
Gemini 4 Carbon 上線:評測、價格與 Fable 5.2、Argon 差異分析
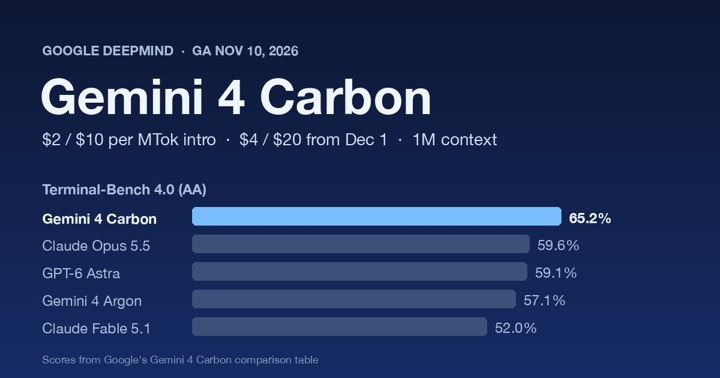
Gemini 4 Carbon 是 Google 目前最強的模型,2026 年 11 月 10 日起開放給開發者、企業與 Google AI Ultra 訂閱者。 Google 官方表格中,Carbon 在 17 項評測拿下 14 項第一;Artificial Analysis 的智慧指數為 60 分,低於前一天推出的 Claude Fable 5.2(65 分),但每個評測任務成本約為 Fable 5.2 的三成,速度也較快。優惠價與 Gemini 4 Argon 相同,11 月 30 日後漲為兩倍。
Gemini 4 Carbon 是什麼?規格一覽
Carbon 以 Gemini 4 Argon 為基礎,定位在長時間代理開發、困難推理、科學研究與資安防禦。10 月 28 日先開放給 Fairwind 計畫的資安防禦者,11 月 10 日全面開放。Google 公告
| 項目 | Gemini 4 Carbon |
|---|---|
| API 模型 ID | gemini-4-carbon |
| 上下文視窗 | 1,048,576 tokens,輸入、思考與輸出共用 |
| 最大輸出 | 同步請求 65,536 tokens;背景模式可延長到接近 100 萬 tokens |
| 輸入 | 文字、圖片、音訊、影片、PDF |
| 輸出 | 文字(不支援圖片、音訊生成與 Live API) |
| 知識截止 | 2026 年 3 月 |
| 思考等級 | low、medium(預設)、high |
| 支援工具 | 函式呼叫、程式碼執行、電腦操作、Google 搜尋與地圖、URL context、File search、結構化輸出 |
| 快取 | 只有隱含快取,4,096 tokens 以上自動啟用;不支援明確快取 |
| 免費層 | 不提供 |
誰可以用?各管道開放狀況
| 對象 | 開放管道 |
|---|---|
| 開發者 | Gemini API 付費層、Google AI Studio、Android Studio;Google AI Ultra 訂閱者另可在 Antigravity 使用 |
| 企業 | Gemini Enterprise(API 或模型選單)、Google Antigravity、CodeMender |
| 一般使用者 | Google AI Ultra 訂閱者,在 Gemini App 與搜尋的 AI 模式陸續開放;公告未提到 Google AI Pro |
| 資安防禦者 | Fairwind 計畫,使用資安專用版本 |
| 研究人員 | 可申請在 Antigravity 最高用量層免費使用 Argon 與 Carbon 6 個月,依資格與容量審核 |
Gemini 4 Carbon 價格:優惠期到 11 月 30 日
單位為 美元/100 萬 tokens,思考 tokens 以輸出計費。Carbon 與 Argon 的價格相同。Gemini API 價格
| 計費項目 | 優惠價(至 11/30) | 12 月 1 日起 |
|---|---|---|
| 輸入 | $2.00 | $4.00 |
| 輸出(含思考) | $10.00 | $20.00 |
| 快取輸入 | $0.10 | $0.20 |
| Batch/Flex 輸入、輸出 | $1.00、$5.00 | $2.00、$10.00 |
| Priority 輸入、輸出 | $3.60、$18.00 | $7.20、$36.00 |
- Google 搜尋接地:每月前 5,000 次免費(Gemini 3 以後的模型共用),之後每 1,000 次 $14,每天上限 1,500 次。
- 與 Claude 比較:12 月起的 $4/$20 與 Claude Opus 5.5 相同,是 Claude Fable 5.2($8/$40)的一半。
官方評測:17 項中 14 項第一
以下是 Google 公布的比較表。表中的 Claude 旗艦是 Fable 5.1,沒有包含前一天推出的 Fable 5.2。Gemini 模型頁
| 評測(領域) | Carbon | Argon | GPT-6 Astra | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|---|
| AA Index v5.0(綜合) | 59 | 50 | 57 | 58 | 49 |
| Vals Index v2.2(綜合) | 70.4% | 69.2% | 65.0% | 70.2% | 未列 |
| SWE-sweep(代理開發) | 9.6% | 未列 | 9.5% | 3.6% | 2.9% |
| FrontierSWE 2(代理開發) | 61.2% | 55.0% | 65.5% | 62.3% | 56.3% |
| Terminal-Bench 4.0(代理開發) | 65.2% | 57.1% | 59.1% | 59.6% | 52.0% |
| Agents’ Last Exam v1.1(電腦操作) | 77.4% | 69.0% | 73.1% | 71.6% | 未列 |
| OSWorld-2.1 離線子集(電腦操作) | 81.5% | 74.7% | 80.9% | 87.2% | 76.8% |
| AutomationBench(知識工作) | 53.9% | 51.3% | 41.4% | 42.5% | 31.4% |
| Vending-Bench 2 帳戶餘額(知識工作) | $16,484 | $13,718 | $15,515 | $9,235 | $5,422 |
| Chartography(多模態) | 72.5% | 71.6% | 71.0% | 66.3% | 46.2% |
| Blueprint-Bench 2(多模態) | 58.6% | 54.4% | 49.7% | 51.2% | 41.9% |
| GraphWalks 256K–1M(長上下文) | 96.2% | 84.2% | 71.8% | 66.8% | 65.0% |
| RiemannBench(數學) | 72.0% | 76.0% | 72.0% | 69.6% | 65.6% |
| Terminal-Bench-Science 0.1(科學) | 64.8% | 52.9% | 63.3% | 59.0% | 43.3% |
| CWE-bench(資安修補) | 71.0% | 68.0% | 68.0% | 67.0% | 58.0% |
| ExploitGym(漏洞利用) | 54.8% | 42.0% | 42.4% | 34.5% | 未列 |
| SEC-bench Pro(漏洞發現) | 88.2% | 83.4% | 85.4% | 未列 | 未列 |
- 落後的 3 項:FrontierSWE 2 輸 GPT-6 Astra,OSWorld-2.1 輸 Opus 5.5,RiemannBench 輸自家的 Argon。
- 差距最大的是長上下文:GraphWalks 96.2%,比第二名 Argon 高 12 個百分點,比 Opus 5.5 高約 29 個百分點。
- 資安分數在沒有防護機制的條件下測得。
- Google 另稱:Carbon 在 CursorBench 4.0、WANDR 與 AutomationBench 排名第一,每任務成本比次佳的外部模型低一半以上;在與 AA 合作推出的 Multimodal Knowledge Agent 評測排第二,平均每任務成本不到第一名的六分之一。
與 Claude Fable 5.2 比較:重疊的 5 項評測
把 Google 表格中 Carbon 的分數,對照 Anthropic 公布的 Fable 5.2 分數。兩家各自執行測試,同一模型的分數也會有落差,例如 Opus 5.5 的 Chartography 在 Google 表中是 66.3%,在 Anthropic 表中是 64.4%。Fable 5.2 產品頁
| 評測 | Gemini 4 Carbon | Claude Fable 5.2 |
|---|---|---|
| FrontierSWE v2 | 61.2% | 69.9% |
| AutomationBench | 53.9% | 51.4% |
| Terminal-Bench-Science 0.1 | 64.8% | 74.6% |
| OSWorld 2.1 | 81.5% | 89.3% |
| Chartography | 72.5% | 73.4% |
完整的 Fable 5.2 分析見 Claude Fable 5.2 是什麼?價格、評測與 Opus 5.5 差異。
獨立測試:AA 第 4 名,成本約 Fable 5.2 的三成
Artificial Analysis(AA)Intelligence Index v5.0.1 排行榜中,前 3 名都是不同 effort 的 Fable 5.2,Carbon(high)排第 4,Opus 5.5(max)排第 5。Google 10 月 28 日公布的「59 分第一」是在 Fable 5.2 推出前的 v5.0 結果。AA 模型頁
| AA 指標 | Gemini 4 Carbon(high) | Claude Fable 5.2(max) |
|---|---|---|
| Intelligence Index | 60(第 4) | 65(第 1) |
| 輸出速度 | 80 tokens/s | 103 tokens/s |
| 第一個答案 token 的等待時間 | 66.85 秒 | 231.55 秒 |
| 每個評測任務耗時 | 25.6 分鐘 | 44.1 分鐘 |
| 每個評測任務成本 | $7.76 | $26.54 |
| 整套評測輸出 tokens | 約 2.05 億 | 約 2.75 億 |
AA 以 12 月起的 $4/$20 計算 Carbon 成本,優惠期內實際花費約為表中的一半。兩者都遠高於同類模型中位數:Carbon 的輸出 tokens 約為中位數(7,280 萬)的 2.8 倍,等待時間約為中位數(12.15 秒)的 5.5 倍。
資安與安全測試結果
| 測試 | Carbon | Argon |
|---|---|---|
| 自適應紅隊代理,單次攻擊突破率 | 0.8% | 3.1% |
| Gray Swan 自動化網路攻擊查詢成功率 | 2.17% | 9.86% |
| Gray Swan 間接提示注入攻擊成功率 | 0% | 0.7% |
| 375 項代理誠實度任務通過率 | 92% | 70% |
- Carbon 擋下自適應紅隊代理 99% 的攻擊路徑。
- 外部機構 Trajectory Labs 測試 132 小時、超過 13,000 次請求,沒有找到新的通用越獄方法。
- 在誠實度測試中,Carbon 98% 拒絕捏造缺少的實驗數據,68% 會指出方法上的缺陷。
- 模型卡列出的限制:會產生幻覺、偶爾變慢或逾時、思考等級越高越耗 tokens;Google 也表示提示注入的防禦仍需改進。安全公告
新功能:Antigravity 的 /swarm 多代理模式
/swarm(預覽)會把一個提示拆成一組協作代理,並即時顯示進度。Carbon 負責架構、協調與審查等高推理角色;較快的模型在各自隔離的工作區平行執行,另有對抗式驗證代理測試變更。Antigravity 的託管代理也支援 Carbon。
開發者遷移重點
從 Argon 換成 Carbon 只要改模型 ID,請求格式不變;但每回合的思考 tokens 較多,延遲較長。從 Gemini 3.x 以前遷移,要處理以下變更:What’s new in Gemini 4 Carbon
- 改用 Interactions API,用
generation_config.thinking_level設定思考等級,多輪狀態用previous_interaction_id保存在伺服器端。 - 移除明確快取:
cachedContents、caches.create不再支援。 - 移除 temperature、top_p、top_k:這些參數會被忽略。
- 提高 max_output_tokens:思考也算在內,原本低於 32K 的要調到至少 32,768。
- 超過 64K 的輸出用背景模式:設定
background: true,伺服器以每段 64K 接續生成,需自行合併。 - 延長逾時:困難請求可能要數分鐘,HTTP 逾時建議至少 15 分鐘。
Carbon、Argon、Fable 5.2 怎麼選
Google 自己的建議是:多數軟體開發與知識工作用 Argon,最困難的問題才用 Carbon。
| 需求 | 較適合的模型 | 原因 |
|---|---|---|
| 一般開發、互動式寫程式、正式環境的快速迴圈 | Gemini 4 Argon | 同價但 tokens 用量少、延遲低 |
| 超長文件、多份資料交叉分析 | Gemini 4 Carbon | GraphWalks 長上下文領先 |
| 困難推理、長時間代理開發且預算有限 | Gemini 4 Carbon | AA 分數接近頂尖,每任務成本約 Fable 5.2 的三成 |
| 追求最高能力、不在意速度與成本 | Claude Fable 5.2 | AA 第一,FrontierSWE、OSWorld 分數較高 |
| 漏洞研究與修補 | Carbon(Fairwind 版) | 三項資安評測領先,需通過 Fairwind 審核 |


