Gemini 4 Carbon 发布:基准测试、价格与 Fable 5.2、Argon 对比分析
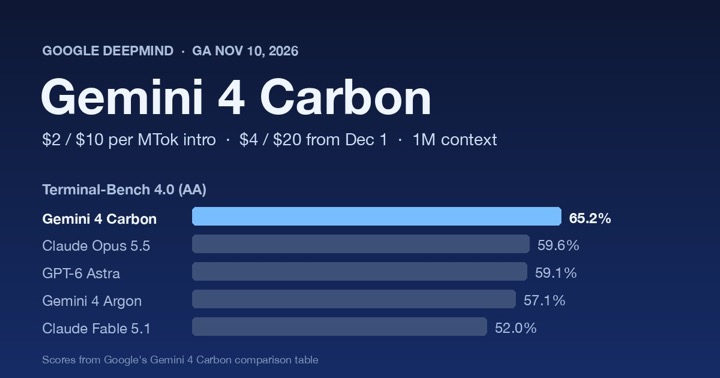
Gemini 4 Carbon 是 Google 目前最强的模型,2026 年 11 月 10 日起向开发者、企业和 Google AI Ultra 订阅用户开放。 在 Google 官方对比表中,Carbon 在 17 项基准测试中拿下 14 项第一;Artificial Analysis 智能指数为 60 分,低于前一天发布的 Claude Fable 5.2(65 分),但单个评测任务成本约为 Fable 5.2 的三成,速度也更快。优惠价与 Gemini 4 Argon 相同,11 月 30 日之后翻倍。
Gemini 4 Carbon 是什么?规格一览
Carbon 基于 Gemini 4 Argon,主打长时间智能体编程、高难度推理、科学研究和安全防御。10 月 28 日先向 Fairwind 计划的安全防御人员开放,11 月 10 日全面开放。Google 公告
| 项目 | Gemini 4 Carbon |
|---|---|
| API 模型 ID | gemini-4-carbon |
| 上下文窗口 | 1,048,576 tokens,输入、思考和输出共用 |
| 最大输出 | 同步请求 65,536 tokens;后台模式可扩展到接近 100 万 tokens |
| 输入 | 文本、图片、音频、视频、PDF |
| 输出 | 文本(不支持图片、音频生成和 Live API) |
| 知识截止 | 2026 年 3 月 |
| 思考等级 | low、medium(默认)、high |
| 支持的工具 | 函数调用、代码执行、电脑操作、Google 搜索与地图、URL context、File search、结构化输出 |
| 缓存 | 仅支持隐式缓存,4,096 tokens 及以上自动启用;不支持显式缓存 |
| 免费层 | 不提供 |
谁能用?各渠道开放情况
| 对象 | 开放渠道 |
|---|---|
| 开发者 | Gemini API 付费层、Google AI Studio、Android Studio;Google AI Ultra 订阅用户还可在 Antigravity 中使用 |
| 企业 | Gemini Enterprise(API 或模型下拉菜单)、Google Antigravity、CodeMender |
| 普通用户 | Google AI Ultra 订阅用户,在 Gemini App 和搜索的 AI 模式中逐步开放;公告未提及 Google AI Pro |
| 安全防御人员 | Fairwind 计划,使用安全专用版本 |
| 科研人员 | 可申请在 Antigravity 最高用量档免费使用 Argon 和 Carbon 6 个月,按资格和容量审核 |
Gemini 4 Carbon 价格:优惠期到 11 月 30 日
单位为 美元/百万 tokens,思考 tokens 按输出计费。Carbon 与 Argon 价格相同。Gemini API 价格
| 计费项 | 优惠价(至 11/30) | 12 月 1 日起 |
|---|---|---|
| 输入 | $2.00 | $4.00 |
| 输出(含思考) | $10.00 | $20.00 |
| 缓存输入 | $0.10 | $0.20 |
| Batch/Flex 输入、输出 | $1.00、$5.00 | $2.00、$10.00 |
| Priority 输入、输出 | $3.60、$18.00 | $7.20、$36.00 |
- Google 搜索接地:每月前 5,000 次免费(Gemini 3 及以后的模型共用),之后每 1,000 次 $14,每天上限 1,500 次。
- 与 Claude 对比:12 月起的 $4/$20 与 Claude Opus 5.5 相同,是 Claude Fable 5.2($8/$40)的一半。
官方基准测试:17 项中 14 项第一
以下为 Google 公布的对比表。表中的 Claude 旗舰是 Fable 5.1,不包含前一天发布的 Fable 5.2。Gemini 模型页
| 基准测试(领域) | Carbon | Argon | GPT-6 Astra | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|---|
| AA Index v5.0(综合) | 59 | 50 | 57 | 58 | 49 |
| Vals Index v2.2(综合) | 70.4% | 69.2% | 65.0% | 70.2% | 未列出 |
| SWE-sweep(智能体编程) | 9.6% | 未列出 | 9.5% | 3.6% | 2.9% |
| FrontierSWE 2(智能体编程) | 61.2% | 55.0% | 65.5% | 62.3% | 56.3% |
| Terminal-Bench 4.0(智能体编程) | 65.2% | 57.1% | 59.1% | 59.6% | 52.0% |
| Agents’ Last Exam v1.1(电脑操作) | 77.4% | 69.0% | 73.1% | 71.6% | 未列出 |
| OSWorld-2.1 离线子集(电脑操作) | 81.5% | 74.7% | 80.9% | 87.2% | 76.8% |
| AutomationBench(知识工作) | 53.9% | 51.3% | 41.4% | 42.5% | 31.4% |
| Vending-Bench 2 账户余额(知识工作) | $16,484 | $13,718 | $15,515 | $9,235 | $5,422 |
| Chartography(多模态) | 72.5% | 71.6% | 71.0% | 66.3% | 46.2% |
| Blueprint-Bench 2(多模态) | 58.6% | 54.4% | 49.7% | 51.2% | 41.9% |
| GraphWalks 256K–1M(长上下文) | 96.2% | 84.2% | 71.8% | 66.8% | 65.0% |
| RiemannBench(数学) | 72.0% | 76.0% | 72.0% | 69.6% | 65.6% |
| Terminal-Bench-Science 0.1(科学) | 64.8% | 52.9% | 63.3% | 59.0% | 43.3% |
| CWE-bench(漏洞修复) | 71.0% | 68.0% | 68.0% | 67.0% | 58.0% |
| ExploitGym(漏洞利用) | 54.8% | 42.0% | 42.4% | 34.5% | 未列出 |
| SEC-bench Pro(漏洞发现) | 88.2% | 83.4% | 85.4% | 未列出 | 未列出 |
- 落后的 3 项:FrontierSWE 2 不敌 GPT-6 Astra,OSWorld-2.1 不敌 Opus 5.5,RiemannBench 不敌自家的 Argon。
- 差距最大的是长上下文:GraphWalks 96.2%,比第二名 Argon 高 12 个百分点,比 Opus 5.5 高约 29 个百分点。
- 安全类分数在不启用防护机制的条件下测得。
- Google 另称:Carbon 在 CursorBench 4.0、WANDR 和 AutomationBench 排名第一,单任务成本比次优的外部模型低一半以上;在与 AA 合作推出的 Multimodal Knowledge Agent 测试中排名第二,平均单任务成本不到第一名的六分之一。
与 Claude Fable 5.2 对比:重叠的 5 项测试
将 Google 表中 Carbon 的得分与 Anthropic 公布的 Fable 5.2 得分对照。两家各自运行测试,同一模型的分数也有出入,例如 Opus 5.5 的 Chartography 在 Google 表中为 66.3%,在 Anthropic 表中为 64.4%。Fable 5.2 产品页
| 基准测试 | Gemini 4 Carbon | Claude Fable 5.2 |
|---|---|---|
| FrontierSWE v2 | 61.2% | 69.9% |
| AutomationBench | 53.9% | 51.4% |
| Terminal-Bench-Science 0.1 | 64.8% | 74.6% |
| OSWorld 2.1 | 81.5% | 89.3% |
| Chartography | 72.5% | 73.4% |
Fable 5.2 的完整分析见 Claude Fable 5.2 是什么?价格、基准测试与 Opus 5.5 区别。
独立评测:AA 第 4 名,成本约为 Fable 5.2 的三成
在 Artificial Analysis(AA)Intelligence Index v5.0.1 排行榜中,前 3 名都是不同 effort 档位的 Fable 5.2,Carbon(high)排第 4,Opus 5.5(max)排第 5。Google 10 月 28 日公布的“59 分第一”是 Fable 5.2 发布前的 v5.0 结果。AA 模型页
| AA 指标 | Gemini 4 Carbon(high) | Claude Fable 5.2(max) |
|---|---|---|
| Intelligence Index | 60(第 4) | 65(第 1) |
| 输出速度 | 80 tokens/s | 103 tokens/s |
| 首个答案 token 等待时间 | 66.85 秒 | 231.55 秒 |
| 每个评测任务耗时 | 25.6 分钟 | 44.1 分钟 |
| 每个评测任务成本 | $7.76 | $26.54 |
| 整套评测输出 tokens | 约 2.05 亿 | 约 2.75 亿 |
AA 按 12 月起的 $4/$20 计算 Carbon 成本,优惠期内的实际花费约为表中的一半。两者都远高于同类模型中位数:Carbon 的输出 tokens 约为中位数(7,280 万)的 2.8 倍,等待时间约为中位数(12.15 秒)的 5.5 倍。
安全测试结果
| 测试 | Carbon | Argon |
|---|---|---|
| 自适应红队智能体,单次攻击突破率 | 0.8% | 3.1% |
| Gray Swan 自动化网络攻击查询成功率 | 2.17% | 9.86% |
| Gray Swan 间接提示注入攻击成功率 | 0% | 0.7% |
| 375 项智能体诚实度任务通过率 | 92% | 70% |
- Carbon 拦截了自适应红队智能体 99% 的攻击路径。
- 外部机构 Trajectory Labs 测试 132 小时、超过 13,000 次请求,未发现新的通用越狱方法。
- 在诚实度测试中,Carbon 98% 拒绝编造缺失的实验数据,68% 会指出方法上的缺陷。
- 模型卡列出的局限:会产生幻觉、偶尔变慢或超时、思考等级越高 tokens 消耗越多;Google 也表示提示注入防御仍需改进。安全公告
新功能:Antigravity 的 /swarm 多智能体模式
/swarm(预览)把一个提示词拆成一组协作智能体,并实时显示进度。Carbon 负责架构、协调和审查等高推理角色;更快的模型在各自隔离的工作区并行执行,另有对抗式验证智能体测试改动。Antigravity 的托管智能体也支持 Carbon。
开发者迁移要点
从 Argon 切换到 Carbon 只需修改模型 ID,请求格式不变;但每轮思考 tokens 更多,延迟更长。从 Gemini 3.x 及更早版本迁移,需要处理以下变更:What’s new in Gemini 4 Carbon
- 改用 Interactions API,用
generation_config.thinking_level设置思考等级,多轮状态通过previous_interaction_id保存在服务端。 - 移除显式缓存:
cachedContents、caches.create不再支持。 - 移除 temperature、top_p、top_k:这些参数会被忽略。
- 调高 max_output_tokens:思考也计入其中,原本低于 32K 的要调到至少 32,768。
- 超过 64K 的输出使用后台模式:设置
background: true,服务端按每段 64K 接续生成,需要自行拼接。 - 延长超时:高难度请求可能需要数分钟,HTTP 超时建议至少 15 分钟。
Carbon、Argon、Fable 5.2 怎么选
Google 自己的建议是:多数软件开发和知识工作用 Argon,最难的问题才用 Carbon。
| 需求 | 更合适的模型 | 原因 |
|---|---|---|
| 日常开发、交互式编程、生产环境快速迭代 | Gemini 4 Argon | 同价但 tokens 消耗少、延迟低 |
| 超长文档、多份资料交叉分析 | Gemini 4 Carbon | GraphWalks 长上下文领先 |
| 高难度推理、长时间智能体编程且预算有限 | Gemini 4 Carbon | AA 分数接近顶尖,单任务成本约为 Fable 5.2 的三成 |
| 追求最高能力、不在意速度和成本 | Claude Fable 5.2 | AA 第一,FrontierSWE、OSWorld 得分更高 |
| 漏洞研究与修复 | Carbon(Fairwind 版) | 三项安全测试领先,需通过 Fairwind 审核 |
延伸阅读:Gemini 4 Argon 发布解读。


