Claude Opus 5.5 发布:AA 登顶、价格降幅与完整评测解读
Claude Opus 5.5 正式发布,在 Artificial Analysis 最新智能指数中以 58 分排名第一。 这次发布同时带来了更高的能力上限和更低的调用单价。不过,58 分对应最高推理强度,而“成本降低 40%”是官方对默认设置下典型任务的估算,不能直接把两者拼成同一种使用体验。
本文核对 Anthropic 公告、API 文档、官方完整评测图和 Artificial Analysis 实时页面,分析性能、计费与迁移细节。这是发布首日的资料分析,尚不包含本站自行运行的模型实测。
发布日期、核心规格与使用入口
Anthropic 标注的发布日期为 2026 年 9 月 22 日,本文在北京时间 9 月 23 日凌晨查核。以下是 API 规格,不应直接理解为每个订阅产品界面都开放同样的上限。官方模型文档
| 项目 | 已确认信息 |
|---|---|
| Claude API 模型 ID | claude-opus-5-5 |
| 上下文窗口 | 100 万 tokens |
| 常规 API 最大输出 | 128K tokens |
| 输入/输出模态 | 文本、图片输入;文本输出 |
| 推理机制 | Adaptive thinking 始终启用,默认 medium |
| Claude 订阅入口 | Pro、Max、Team、Enterprise |
| 开发者入口 | Claude API、Amazon Bedrock、Claude Platform on AWS、Google Cloud、Microsoft Foundry |
订阅可用性见 Opus 产品页,云平台列表见 API 更新日志。实际访问仍取决于平台和账户配置。
AA 登顶的关键条件:max 与默认 medium 差多少
查核时,Artificial Analysis Intelligence Index v4.3.2 的 Opus 5.5 页面显示 58 分、排名第一。首页上 Fable 5.1 和 GPT-6 Astra 均显示 53 分。这些是页面展示的整数值;两个 Claude 条目带有 max with fallback,Astra 则标注 max。AA 实时排行榜
AA 已提供五档 Opus 5.5 评测。下表均启用 Default Fallback;输出 token 数是完整 Intelligence Index 测试的累计量,不代表一次回答的长度,也不是上下文窗口大小。
| 推理强度 | AA 智能指数 | 整套评测累计输出 tokens |
|---|---|---|
| max | 58 | 约 2.6 亿 |
| xhigh | 56 | 约 1 亿 |
| high | 54 | 约 5,300 万 |
| medium | 51 | 约 3,800 万 |
| low | 42 | 约 2,000 万 |
我的判断是:日常编程先比较 medium 和 high,把 max 留给确实需要更深推理的任务。 按页面的近似值计算,max 比 medium 高 7 分,累计输出量却约为后者的 6.8 倍。这不能直接换算成费用倍数,因为输入、缓存和其他成本还没算进去,但能说明榜首配置与日常默认配置是两回事。
发布初期,AA 新模型页面的速度和单任务成本仍为 N/A,部分价格字段显示 $0.00,与官方收费标准不符。本文不把这些字段视为免费调用依据,也不推导尚未给出的实测速率,计费以 Anthropic 文档为准。AA 模型页
官方九项基准:编程表现突出,但并非所有项目第一
下表按 Anthropic 官方比较图整理,并与公告核对。官方测试汇总和 AA 综合智能指数采用不同口径,不可混用。“未列”表示图中没有给出成绩,不等于零分。官方发布公告
| 基准测试 | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 55.8% | 52.3% | 57.9% | 37.3% |
| FrontierCode v1.1(Main) | 54.4% | 50.3% | 48.0% | 53.3% | 47.5% |
| CursorBench 4.0 | 57.8% | 51.8% | 46.6% | 未列 | 41.7% |
| GDPval-AA v2.1 | 1846 | 1735 | 1708 | 1542 | 1588 |
| AutomationBench | 40.0% | 31.4% | 26.9% | 41.4% | 28.8% |
| Humanity’s Last Exam(使用工具) | 67.7% | 65.6% | 63.6% | 57.2% | 未列 |
| Terminal-Bench-Science 0.1 | 58.7% | 52.6% | 29.0% | 64.6% | 22.4% |
| OSWorld 2.0(partial) | 81.8% | 80.7% | 74.0% | 未列 | 未列 |
| Chartography(使用工具) | 89.0% | 88.4% | 83.4% | 未列 | 未列 |
GDPval-AA 的数值是评分,不是百分比;表中保留了 OSWorld 的 partial 和工具使用条件,避免把不同指标当作统一的正确率。
Terminal-Bench 上,Opus 5.5 比 Opus 5 高 14.1 个百分点,比 Astra 高 8.5 个百分点。但 FrontierCode 对 Astra 的优势只有 1.1 个百分点,AutomationBench 和代理科学研究则仍由 Astra 取得表中最高分。“全面碾压所有任务”并不是这组数据能支持的结论。
还应把图下注释一起读完:
- Opus 5.5 多数测试采用 max,Terminal-Bench 使用 xhigh;Astra 在该项使用 high。这不是同一 effort 下的对照测试。
- 生产防护机制开启,部分任务会回退到旧模型;Zapier 执行的 AutomationBench 不使用回退,防护拦截计为失败。
- Opus 5.5 的 Terminal-Bench 标准误为 ±2.6 个百分点;科学研究测试各模型约为 ±3.5–5 个百分点,小幅领先不等于稳定胜出。
展开官方完整评测图与测试注释
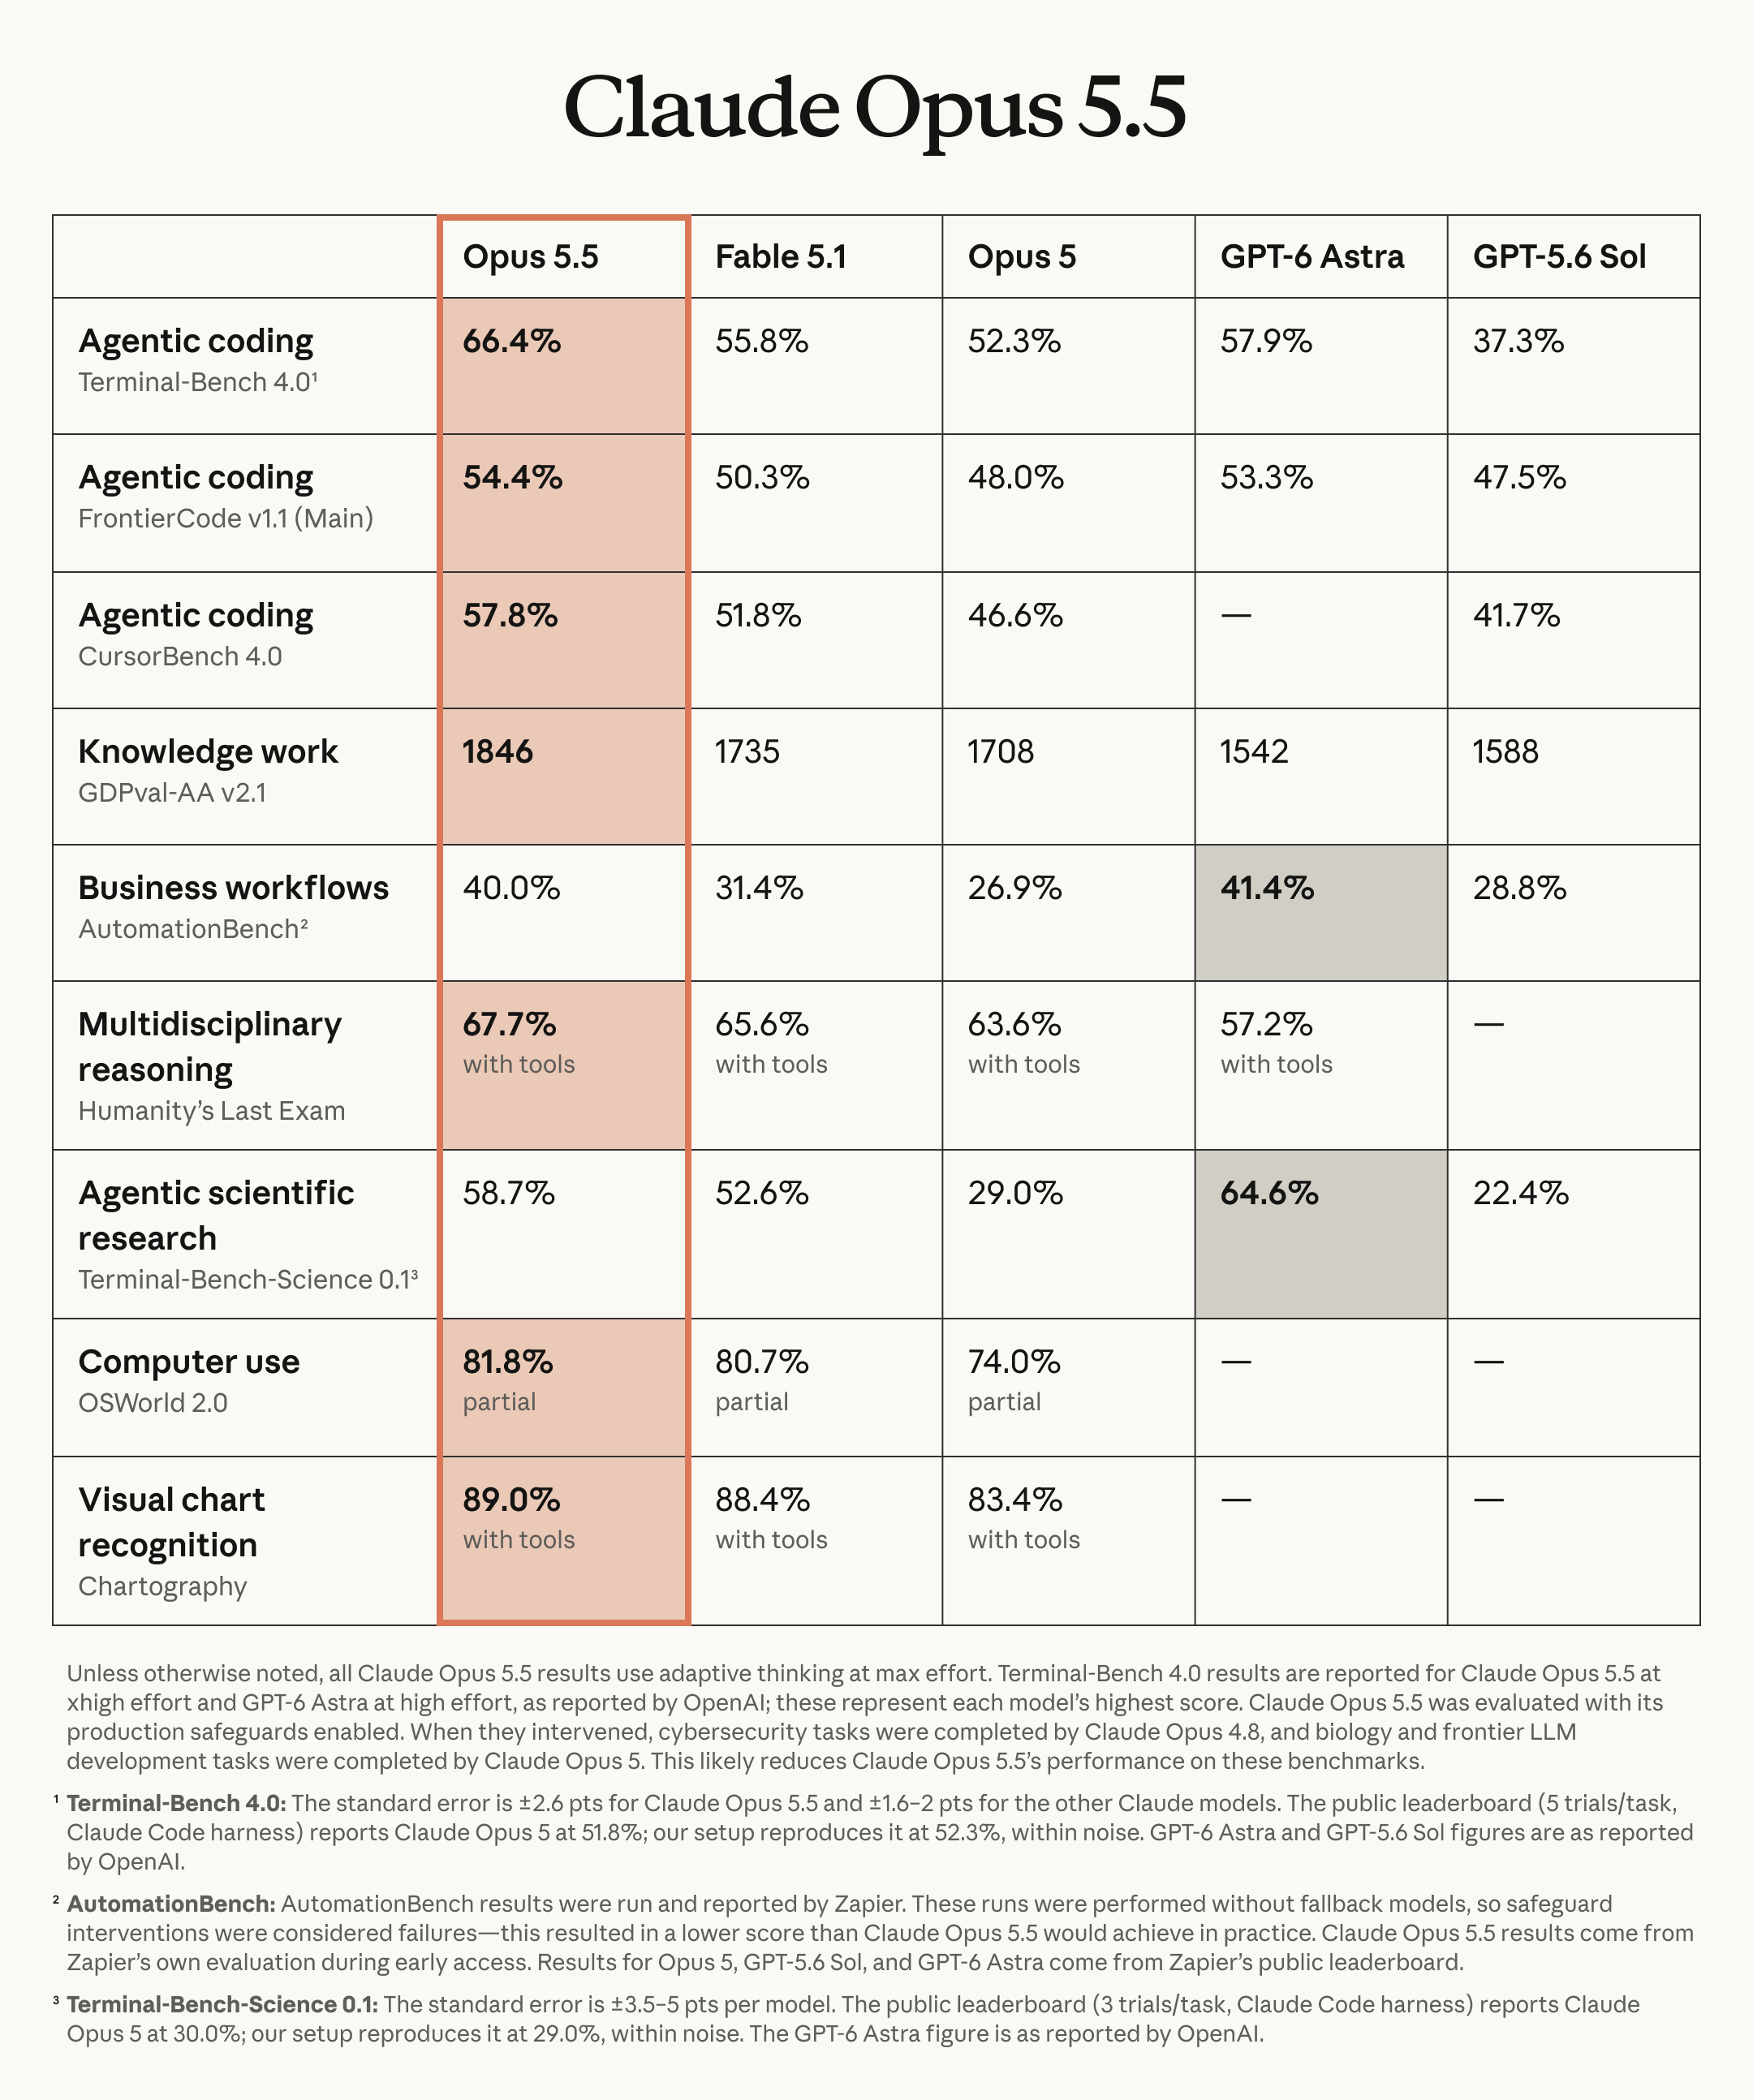
图片来源:Anthropic 官方发布资料,保留原图数据与注释。
API 价格:单价降低 20%,缓存读取降低 60%
标准 Claude API 的计费如下,单位为 美元/100 万 tokens。官方价格文档
| 计费项目 | Opus 5 | Opus 5.5 | 单价降幅 |
|---|---|---|---|
| 普通输入 | $5 | $4 | 20% |
| 输出 | $25 | $20 | 20% |
| 5 分钟缓存写入 | $6.25 | $5 | 20% |
| 1 小时缓存写入 | $10 | $8 | 20% |
| 缓存命中读取 | $0.50 | $0.20 | 60% |
官方宣传的 40% 是典型任务总成本的估计降幅,同时考虑了单价和 token 使用效率,并非全部项目都按六折收费。官方还表示输出生成速度提升超过 30%,但完整任务还包含推理、工具调用和等待,不能据此承诺项目交付也一定快 30%。发布公告
举一个固定用量的算例:100 万未缓存输入 tokens,加上 20 万输出 tokens,不含工具等额外费用,Opus 5 要 $10,Opus 5.5 要 $8,节省 20%。只有进一步减少重试、输出量或重复读取成本,总费用才会继续降低。
对需要反复读取同一代码库的智能体,1,000 万缓存读取 tokens 的费用由 $5 降为 $2;首次缓存写入和输出仍另外计费。
Fast mode 采用更高单价:输入 $8、输出 $40,官方称速度最高可达普通模式的 2.5 倍,需要单独核算。相比 Fable 5.1 的 $10/$50,Opus 5.5 普通输入和输出单价低 60%,但同样不能等同于所有任务都便宜 60%。Opus 产品页、模型规格对比
订阅额度也调整了,重置可以留到需要时再用
Anthropic 宣布提高 Pro、Max、Team 的五小时用量上限,并向订阅用户提供可自主选择使用时机的额度重置。公告没有给出统一增幅,因此不应写成所有套餐额度翻倍。官方公告
符合条件的账户可在网页版或桌面版 Settings → Usage → Resets → Reset for free 操作。重置五小时还是每周额度、何时到期,以账户显示为准。移动端和 Claude Code 终端当前没有该按钮,但操作后额度在账户内共享。官方额度重置说明
API 降价并不等于订阅月费同步下调。需要比较购买方案时,可参考本站的 AI 编程工具订阅对比,同时注意其中的数据日期。
API 迁移必须处理的四项不兼容变更
在 Claude 界面切换模型,与升级自建 Messages API 集成,是两种不同操作。后者不要只替换模型 ID 就直接切换线上流量。
- 不能禁用 thinking:
thinking.type: "disabled"和旧的"enabled"会触发 400,改用 effort 调节推理强度。 - 不再支持强制调用工具:
tool_choice的any、tool会报错,应评估auto与 strict tool use 或 structured outputs。strict 约束参数格式,不保证一定发起工具调用。API 更新日志 - thinking blocks 与模型、对话绑定:重写 system、工具或历史消息可能导致已有 thinking blocks 失效,跨模型路由也要检查兼容性。
- computer use 分平台迁移:Claude API 和 Google Cloud 改用
computer_toolset_20260801;Amazon Bedrock 仍支持computer_20251124。官方迁移指南
另一个容易被漏掉的变化是:工具调用之间的进度说明进入 thinking blocks,默认显示设置下文本为空。如果你的前端只把 text blocks 当成进度消息,升级后就可能看起来一直没响应,需要同步调整解析逻辑。官方响应格式说明
实际选型:用可验收的任务决定默认模型
已经使用 Opus 5 编程的开发者,值得优先测试 Opus 5.5。 选择一个结果可验证的真实任务,记录代码是否通过测试、人工修订次数、耗时和总费用,再决定默认 effort。AA 的五档结果提供了测试顺序的线索,不替代你自己的验收标准。
以科学研究、跨系统业务流程为主的用户,仍应保留 Astra 做同题比较。准备从 Fable 5.1 切换的人,则应先确认关键任务的质量,再计算单价收益。
with fallback 也要纳入测试记录:官方帮助文档说明,部分请求会切换到其他模型,界面会标明由哪个模型作答。评测自己的工作流时,需要确认真正完成任务的模型。官方模型切换说明
本文采用 2026 年 9 月 23 日凌晨查核的资料,排行榜和账户权益会继续变化。Sonnet 5.5、Haiku 5.5 目前只是官方预告将在未来几周推出,不能当作已经同步上线。发布公告