
Artificial Analysis 是什麼?Intelligence Index、速度與成本怎麼看
Artificial Analysis(artificialanalysis.ai)是一個獨立的 AI 模型評測網站:它用自己的測試環境,把各家 LLM 放在同一套題目與 API 測速條件下,比較「多聰明(Intelligence Index)、多快(輸出速度與延遲)、多貴(Cost per Task)」。 想知道新模型是否真的比較強、或在預算內該選哪個 API,看它的 Leaderboards → Models 一頁就能得到第一輪答案。本文說明各指標怎麼讀、目前(2026 年 10 月)的計分方式,以及不同情境該看哪張圖。
Artificial Analysis 網站有哪些頁面
公開頁面可免費瀏覽(另有付費 Premium)。選 LLM 最常用的是下列幾頁:
| 頁面 | 用途 |
|---|---|
| Models | 所有圖表:智能、Token 用量、成本、速度、延遲、端對端時間、上下文長度 |
| Leaderboards → Models | 一張表看完 Intelligence Index、Cost per Task、輸出速度、延遲 |
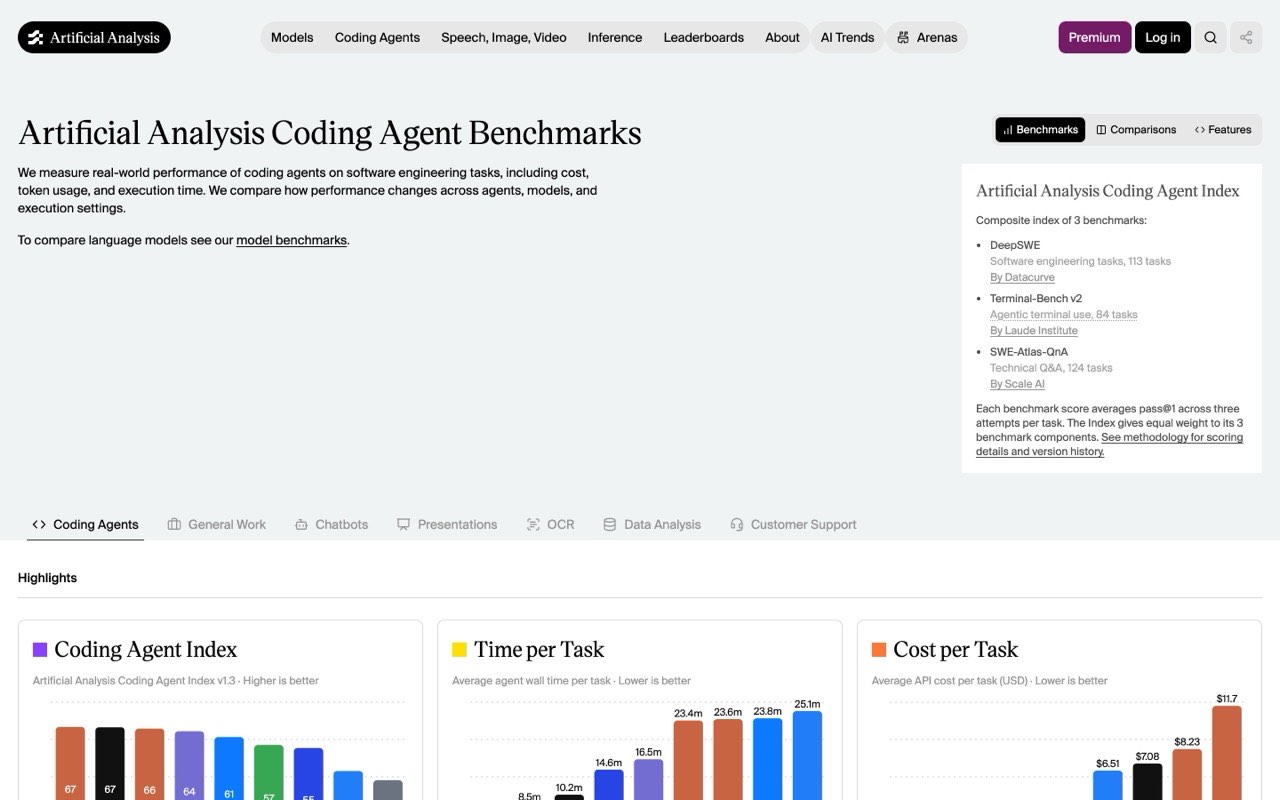
| Coding Agents | 寫程式代理的 Coding Agent Index、單題耗時與花費 |
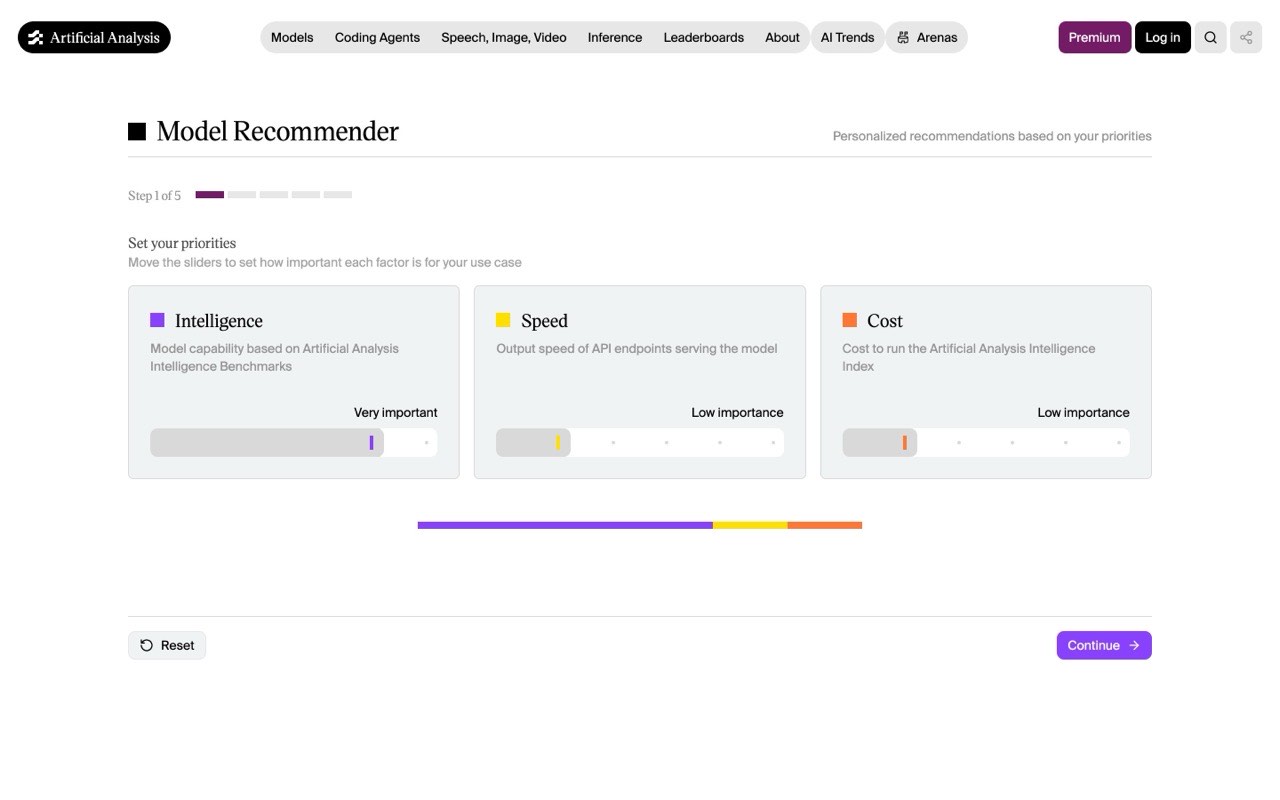
| Model Recommender | 拉滑桿設定智能/速度/成本權重,推薦模型 |
| Leaderboards → Providers | 同一個開源模型在不同雲端供應商上的速度與價格 |
| Image、Video、Speech | 圖片、影片、語音模型的盲測競技場與排行 |
如果你還在比較 LMArena、SWE-bench 等其他榜單的差異,可以先看AI 模型排行榜怎麼看?LMArena、SWE-bench、LiveBench 與 12 個關鍵指標。
Intelligence Index 是什麼?v4.3.2 的 10 項評測
Artificial Analysis Intelligence Index 是把多項評測加權後的綜合分數,分數越高代表整體能力越強。依官方 Intelligence Benchmarking 方法論,2026 年 9 月起的 v4.3.2 由 4 大類、10 項評測組成:
| 類別(權重) | 評測與權重 |
|---|---|
| Agents(30%) | AA-Briefcase v1.1 15%、GDPval-AA v2.1 10%、AutomationBench-AA 5% |
| Coding(20%) | Terminal-Bench 4.0 10%、SciCode 10% |
| General(30%) | AA-Omniscience 15%、GDP.pdf 10%、AA-LCR v1.1 5% |
| Scientific Reasoning(20%) | Humanity’s Last Exam 10%、CritPt 10% |
讀分數時要注意三件事:
- 版本會改,跨版本分數不能直接比。 光 2026 年就從 v4.0 改到 v4.3.2,例如 v4.2 移除了 GPQA Diamond、v4.3 把 Terminal-Bench 2.1 換成 4.0。舊文章或舊截圖的分數(包括本文 8 月的截圖)不能跟現在的分數比較。
- 同一模型會依推理強度分成多筆。 例如 Claude Opus 5.5 (max)、(xhigh)、(high) 是同一模型的不同設定,分數、成本、延遲差很多,選的時候要對到你實際會用的設定。
- 小燈泡圖示代表推理(Reasoning)模型,它們會先產生思考 Token,影響成本與延遲。
速度、延遲與成本怎麼看
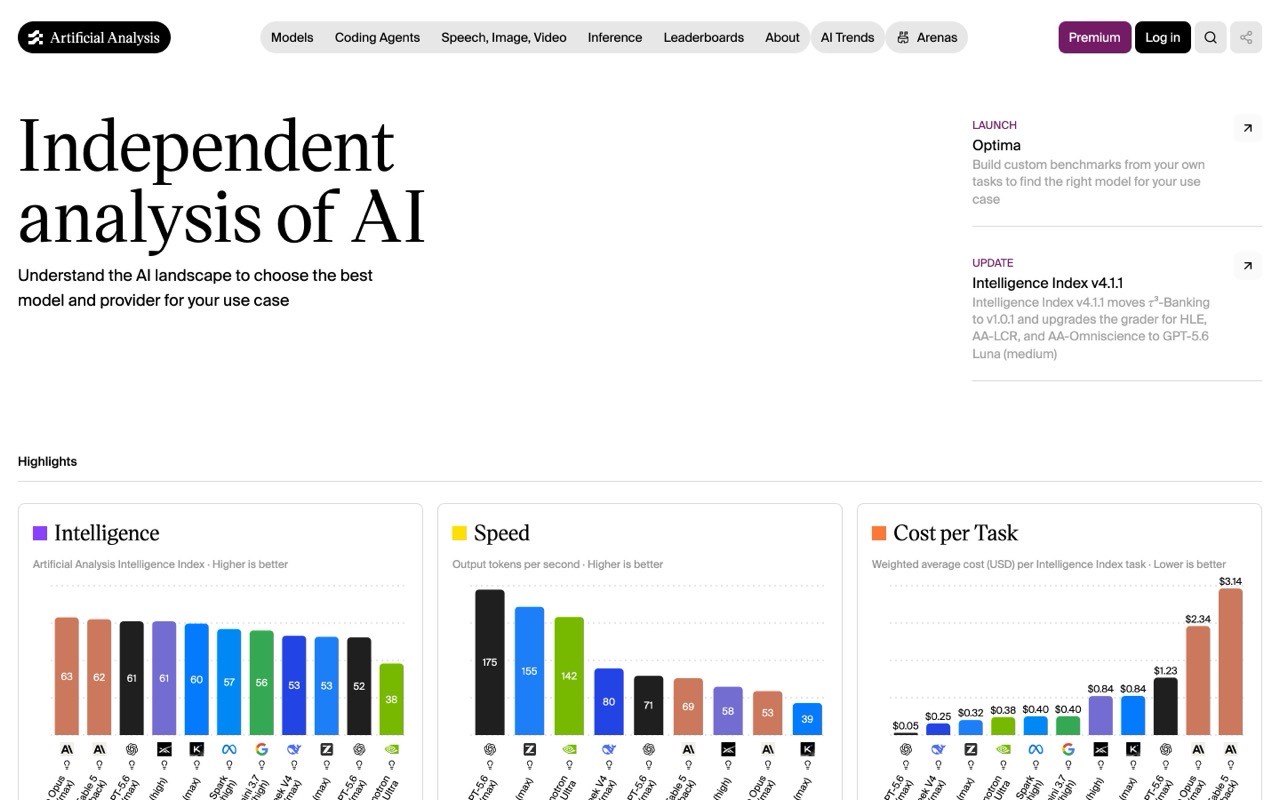
首頁與 Models 頁的指標定義如下(依官方 Performance Benchmarking 方法論 與圖表說明):
| 指標 | 定義 | 怎麼用 |
|---|---|---|
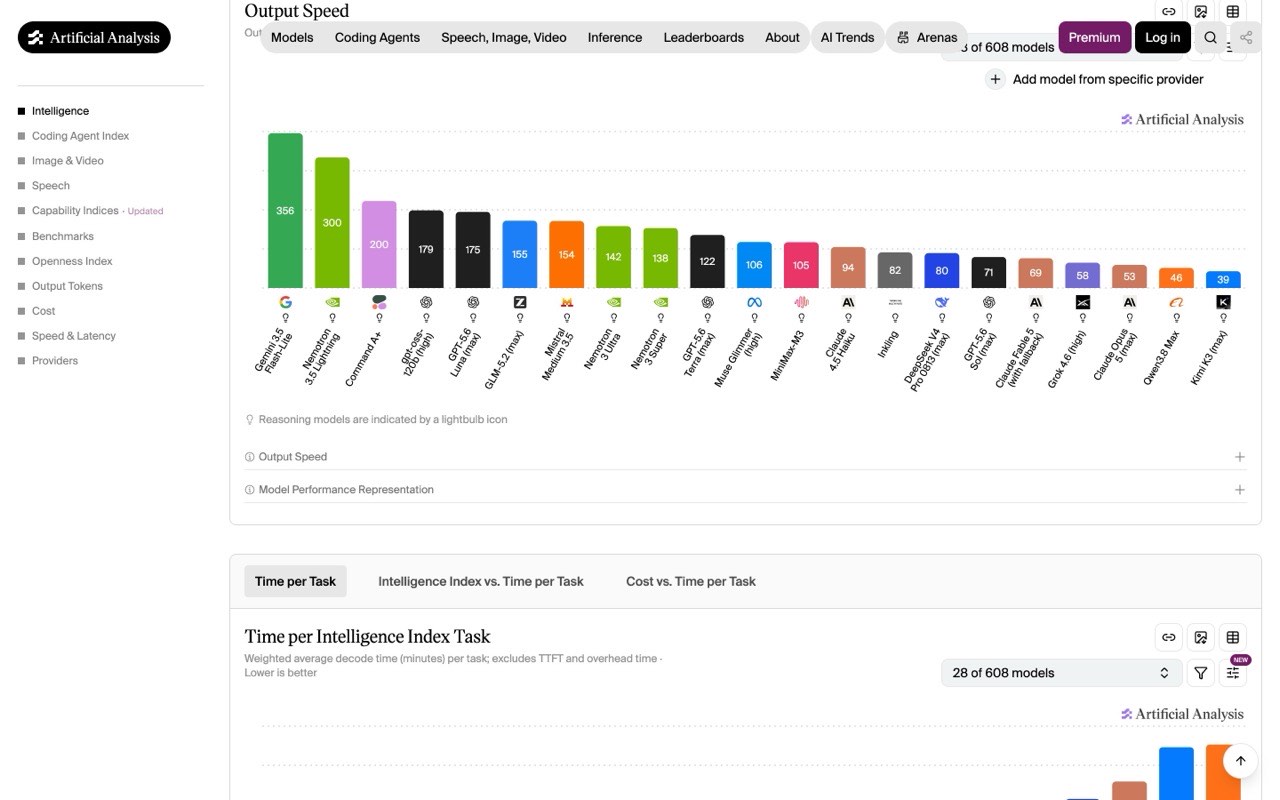
| Output Speed(tokens/s) | 收到第一個 chunk 之後,每秒收到的 Token 數 | 長文生成、串流體感 |
| Latency / Time to First Token | 送出請求到收到第一個 Token 的秒數 | 即時對話、補全 |
| Time to First Answer Token | 推理模型含「思考時間」後,收到第一個答案 Token 的秒數 | 推理模型的實際等待感 |
| End-to-End Response Time | 輸出 500 個 Token 所需秒數,含延遲與思考時間 | 單次請求總等待時間 |
| Cost per Task(USD) | 跑一題 Intelligence Index 評測的加權平均花費,含輸入、快取、推理與答案 Token | 比較「完成工作的實際成本」 |
| Price(USD / 1M Tokens) | 各模型的快取命中、輸入、輸出牌價與 Blended Price | 估算自己的 API 帳單 |
速度數字取自模型原廠 API,或多家供應商的中位數;每天測 8 次,顯示過去 72 小時的中位數(P50),所以會隨尖峰時段與供應商負載變動。
Cost per Task 比牌價更有參考價值:推理模型牌價便宜但思考 Token 多時,實際帳單可能比牌價貴的模型還高。若要看總額,Models 頁的 Cost to Run Artificial Analysis Intelligence Index 會把跑完整套評測的費用拆成 Output、Reasoning、Cache 等部分。
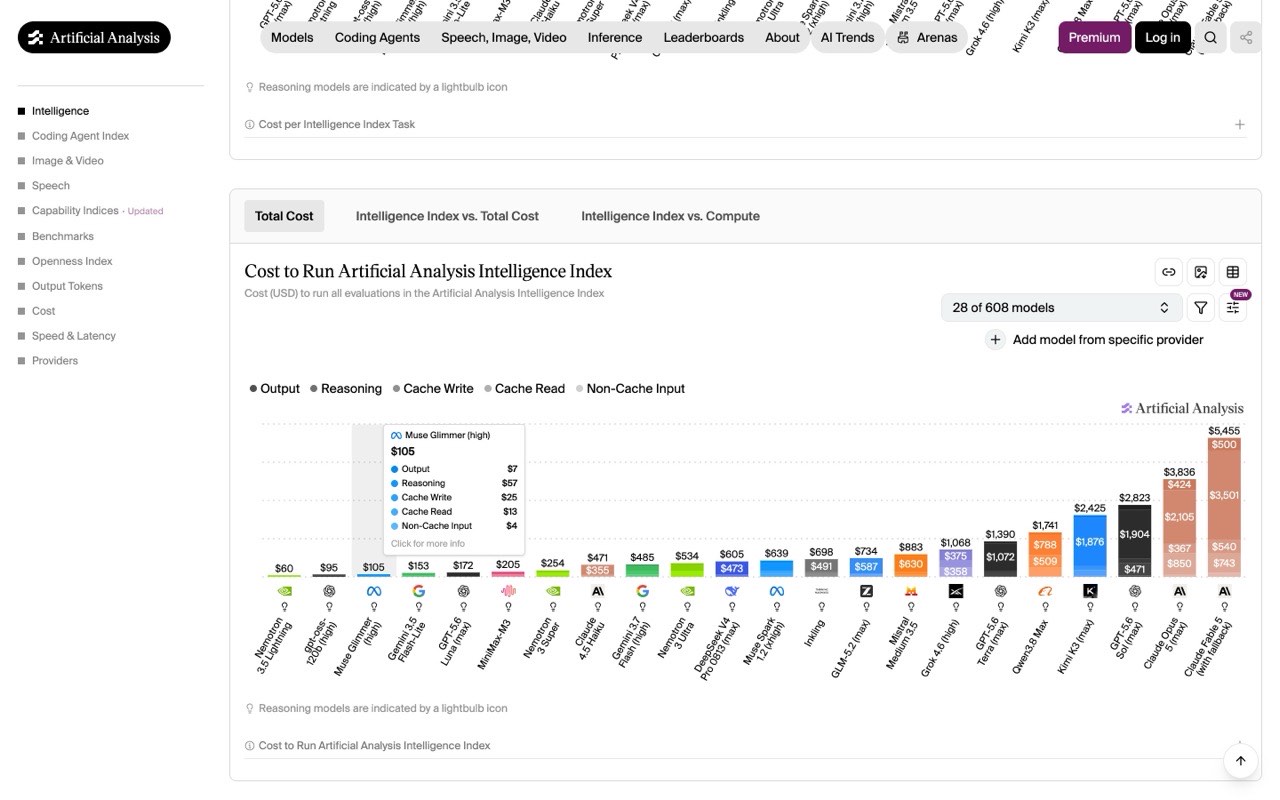
2026 年 10 月排行榜快照
以下是 2026 年 10 月 19 日 Leaderboards → Models 的部分數據(Intelligence Index v4.3.2,數字會隨時更新):
| 模型(設定) | Intelligence Index | Cost per Task | 輸出速度(t/s) | 首個 chunk 延遲(秒) |
|---|---|---|---|---|
| Claude Opus 5.5 (max) | 58 | $5.98 | 98 | 562.75 |
| Claude Sonnet 5.5 (max) | 56 | $5.46 | 136 | 391.60 |
| Claude Opus 5.5 (xhigh) | 56 | $3.46 | 85 | 115.10 |
| Claude Opus 5.5 (high) | 54 | $1.82 | 82 | 40.49 |
| GPT-6 Astra (max) | 53 | $3.26 | 69 | 292.33 |
| Gemini 4 Argon (high) | 53 | $1.99 | 無資料 | 無資料 |
| GPT-6.1 Sol (max) | 52 | $0.72 | 60 | 239.97 |
| Claude Sonnet 5.5 (xhigh) | 52 | $2.01 | 112 | 36.17 |
從這張表可以讀出兩個選型重點:
- 最高分不等於最划算。 GPT-6.1 Sol (max) 只比榜首低 6 分,Cost per Task 卻不到八分之一。
- max 設定的首個 chunk 延遲動輒數分鐘,適合背景批次與代理任務,不適合需要即時回應的介面。
各模型發表時的詳細評測可參考Claude Opus 5.5 上線:AA 登頂、價格降幅與完整評測解析與GPT-6 Sol、Luna 上線:Artificial Analysis 評分、價格與選型。
用帕雷托前沿挑性價比模型
Models 頁的 Intelligence Index vs. Cost per Task 散點圖是選型最實用的一張圖:
- 縱軸是智能分數(越上面越強),橫軸是 Cost per Task(越左邊越便宜)。
- 左上的 Most attractive quadrant 是又強又便宜的區域。
- Pareto line(帕雷托前沿線) 連起「同價位最強、同分數最便宜」的模型。落在線上的是該價位的最佳選擇;離線越遠的模型,代表已有別的模型又強又便宜,可以直接跳過。
同一區還有 Intelligence Index vs. Time per Task、vs. Output Speed、vs. End-to-End Response Time,用法相同,只是把成本換成時間。
不同情境該看哪張圖
| 情境 | 優先看 | 判斷方式 |
|---|---|---|
| 即時聊天、語音助理、IDE 補全 | Latency、Output Speed | 選首 Token 延遲低、速度高的模型或低推理設定 |
| 大量 API 呼叫、批次文件處理 | Intelligence Index vs. Cost per Task | 挑帕雷托前沿上、分數夠用的最便宜模型 |
| Coding Agent(Claude Code、Codex 這類工具) | Coding Agents 頁 | 分數、Time per Task、Cost per Task 一起看 |
| 金融、法律、醫療等產業 | Capability Indexes | 看對應產業的子指數,而非總分 |
| 開源模型自架或選雲端供應商 | Leaderboards → Providers | 同模型不同供應商的速度與價格 |
| 拿不定主意 | Model Recommender | 依權重產生推薦清單 |
Coding Agents 頁的 Coding Agent Index v1.5 由三項評測等權重組成,每題跑 3 次取 pass@1 平均:
- DeepSWE v1.1(Datacurve):113 題真實軟體工程任務
- Terminal-Bench 4.0(Laude Institute):66 題終端機代理任務
- SWE-Atlas-QnA(Scale AI):124 題程式庫技術問答
同頁另有單題耗時、花費、Token 用量,以及新加入的安全拒答率與 Reward Hacking 比率。分數差幾分時,耗時與花費往往才是決定日常是否好用的因素。工具層面的差異可參考AI coding 工具比較:Claude Code、Codex、Cursor 怎麼選?。
Model Recommender 共 5 個步驟,第一步用滑桿設定 Intelligence、Speed、Cost 的重要程度,最後依權重產生推薦模型。
使用 Artificial Analysis 的限制
- 總分是平均值:Intelligence Index 偏重代理任務(Agents 佔 30%),你的工作若是翻譯、客服或單純分類,總分高低不一定反映實際表現。
- 速度會隨供應商與時段變動:72 小時中位數適合比較,不代表你上線後的 P95 延遲。
- 價格以官方牌價為準:下單前請到各家官方定價頁確認,並自己加上快取、批次折扣的效果。
- 最後仍要用自己的資料測:官方另有 Optima 可用自己的任務建立自訂評測;也可以拿前 2–3 名候選模型,用 20–50 筆真實案例實測。


