
Claude Fable 5.2 是什麼?價格、評測與 Opus 5.5 差異完整分析
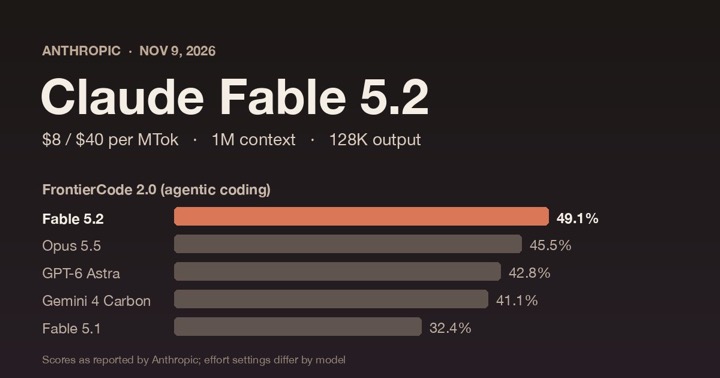
Claude Fable 5.2 是 Anthropic 在 2026 年 11 月 9 日推出的最高階公開模型,定位在長時間代理工作與困難推理。 API 單價比 Fable 5.1 低 20%,官方公布的 12 項評測中有 10 項第一,Artificial Analysis 的獨立測試也排第一;但它的單價仍是 Opus 5.5 的兩倍,速度在同類模型中偏慢。
Claude Fable 5.2 是什麼?與 Mythos 5.2 有何不同
Fable 5.2 與 Mythos 5.2 是同一個底層模型。Fable 5.2 加上網路安全與生物領域的防護,開放給所有使用者;Mythos 5.2 放寬這兩類防護,只提供給通過 Anthropic 驗證計畫的組織。官方公告
| 項目 | Claude Fable 5.2 |
|---|---|
| 發布日期 | 2026 年 11 月 9 日 |
| API 模型 ID | claude-fable-5-2 |
| 上下文視窗 | 100 萬 tokens |
| 最大輸出 | 128K tokens |
| 輸入/輸出 | 文字與圖片輸入,文字輸出 |
| 知識截止 | 2026 年 6 月 |
| 推理方式 | Adaptive thinking 固定開啟,用 effort 調整深度 |
| 預設 effort | API 為 high;Claude App 與 Claude Code 為 medium |
| 訂閱方案 | Pro、Max、Ultra、Team、Enterprise |
| 雲端平台 | Claude API、Amazon Bedrock、Claude Platform on AWS、Google Cloud、Microsoft Foundry |
| 最早退役時間 | 不早於 2027 年 11 月 9 日 |
規格來源:Fable 5.2 模型文件、Fable 產品頁。
Fable 5.2 價格:比 5.1 便宜 20%,仍是 Opus 5.5 的兩倍
單位為 美元/100 萬 tokens。Fable 5.1 的快取讀取與 Batch 價格依官方公布的倍率換算。官方新功能說明
| 計費項目 | Fable 5.1 | Fable 5.2 | Opus 5.5 |
|---|---|---|---|
| 輸入 | $10 | $8 | $4 |
| 輸出 | $50 | $40 | $20 |
| 快取讀取 | $0.25 | $0.20 | $0.20 |
| Batch 輸入/輸出 | $5/$25 | $4/$20 | $2/$10 |
| Fast mode 輸入/輸出 | 未列 | $16/$80 | $8/$40 |
- **快取讀取只收輸入價的 2.5%**,Opus 5.5 是 5%,所以兩者的快取讀取單價相同。反覆讀取大型程式碼庫的代理工作,價差主要落在未快取的輸入與輸出。
- Fast mode 官方稱最高可達 2.5 倍生成速度,單價是標準模式的兩倍。
Fable 5.2 用量是獨立的嗎?各方案怎麼算
Fable 沒有獨立額度。 Max、Ultra 與 Team 進階席位使用 Fable,會扣同一份每週額度,而且消耗得比其他模型快。Pro 與 Team 標準席位平常不含 Fable,使用時改扣 usage credits,不占方案額度。官方推出優惠說明
| 方案 | Fable 平常怎麼計算 | 推出優惠 |
|---|---|---|
| Pro、Team 標準席位 | 扣 usage credits(需自行開啟) | 2026 年 11 月 9 日至 16 日可用每週額度的 50% 使用 Fable,另有 1 次 Fable 重設,11 月 16 日到期 |
| Max、Ultra、Team 進階席位、舊版席位制 Enterprise 進階席位 | 與其他模型共用每週額度 | 依訂閱時長取得 1 到 3 次 Fable 重設,2027 年 3 月 8 日到期 |
- 重設次數:從第一次付費帳單起算,未滿 6 個月 1 次,6 到 12 個月 2 次,超過 12 個月 3 次。
- 重設的效果:退回每週額度中已花在 Fable 的用量,其他模型的用量不變;有五小時額度的帳戶會整段補滿。重設不會提高上限。
- 不適用:Free、舊版席位制 Enterprise 標準席位、自助式 Enterprise、用量計費 Enterprise、HIPAA Enterprise。
- 使用方式:Settings → Usage,在額度重設中選擇免費重設;優惠涵蓋 Fable 5.2、5.1 與 5。重設流程見 Claude Banked Reset 怎麼用。
官方評測:12 項中 10 項第一,但有兩項落後
以下數字來自 Anthropic 官方比較表,採各模型可用的最高 effort(另有標示者除外),並開啟正式環境防護。Mythos 專用的三項資安與蛋白質評測不列入。Fable 產品頁
| 評測(領域) | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| FrontierCode 2.0(代理開發) | 49.1% | 32.4% | 45.5% | 42.8% | 41.1% |
| FrontierSWE v2(代理開發) | 69.9% | 56.3% | 62.3% | 65.5% | 61.2% |
| AutomationBench(商業流程) | 51.4% | 31.4% | 42.5% | 41.4% | 53.9% |
| Terminal-Bench-Science 0.1(科學研究) | 74.6% | 52.6% | 58.7% | 68.1% | 64.8% |
| WANDR(代理搜尋) | 82.1% | 68.7% | 72.3% | 未列 | 未列 |
| OSWorld 2.1(電腦操作) | 89.3% | 83.5% | 87.2% | 79.5% | 81.5% |
| RoboDojo Sim(機器人) | 64.9% | 27.6% | 39.4% | 29.8% | 未列 |
| AA-Briefcase v1.1 評分(知識工作) | 66.1% | 61.5% | 61.2% | 52.0% | 61.8% |
| AA-Briefcase v1.1 Elo(知識工作) | 1785 | 1669 | 1800 | 1569 | 1611 |
| Remote Labor Index(遠端工作) | 41.3% | 17.9% | 21.3% | 20.8% | 未列 |
| Humanity’s Last Exam(含工具) | 74.2% | 65.6% | 67.7% | 57.2% | 未列 |
| Chartography(圖表判讀,無工具) | 73.4% | 44.8% | 64.4% | 71.0% | 72.5% |
閱讀這張表要注意:
- 不是每項第一:AutomationBench 最高的是 Gemini 4 Carbon,AA-Briefcase 的 Elo 最高是 Opus 5.5。
- effort 設定不一致:FrontierCode 的 Fable 兩代用 Xhigh,Gemini 4 Carbon 用 Medium;Remote Labor Index 的 Fable 5.2 用 High。
- 部分是內部測試:RoboDojo Sim 由 Anthropic 自行執行,方法說明在系統卡中。
- 進步幅度最大的項目:相較 Fable 5.1,RoboDojo Sim 從 27.6% 升到 64.9%,Remote Labor Index 從 17.9% 升到 41.3%,Chartography 從 44.8% 升到 73.4%。
獨立測試:Artificial Analysis 排名第一,但最慢也最貴
Artificial Analysis(AA)以 max effort 測試 Fable 5.2。速度與延遲取過去 5 天平均,查核日期為 2026 年 11 月 10 日。AA 模型頁
| AA 指標 | Fable 5.2(max) | 同類模型中位數 |
|---|---|---|
| Intelligence Index | 65 分,74 個模型中第 1 | 40 分 |
| 輸出速度 | 103 tokens/s,73 個中第 72 | 未列 |
| 第一個答案 token 的等待時間 | 231.55 秒 | 13.07 秒 |
| 每個評測任務耗時 | 44.1 分鐘 | 12.9 分鐘 |
| 每個評測任務成本 | $26.54,73 個中最高 | 未列 |
| 整套評測輸出 tokens | 約 2.75 億 | 約 7,280 萬 |
AA 的結果與官方方向一致:能力上限最高,但 max 設定下的等待時間與成本都明顯高於其他模型。這是 max 的數字,不代表 medium 或 high 的日常使用體驗。
Effort 怎麼選:官方稱低設定就能追上 Opus 5.5
Anthropic 公布了 Fable 5.2 在較低 effort 下與 Opus 5.5 最高設定的比較。官方公告
| 評測 | Fable 5.2 設定與結果 | Opus 5.5 最高設定 | 官方稱每任務成本 |
|---|---|---|---|
| FrontierCode 2.0 | High,45.3% | 45.5% | 約一半 |
| WANDR | Medium,追平 Opus 最高分 | 72.3% | 約 40% |
| Humanity’s Last Exam | Low,追平 Opus 最高分 | 67.7% | 不到十分之一 |
| Chartography | Medium,66.4% | 64.4% | 不到十分之一 |
API 文件的建議是從預設的 high 開始;最難的長時間開發工作且實測有提升時再用 xhigh;max 只用來測能力上限,或用在不在乎時間與 token 的少數任務。Effort 文件
安全防護:誤擋減少 55%,但資安任務仍要用 Mythos
| 項目 | 內容 |
|---|---|
| 會被擋的請求 | 滲透測試、漏洞利用程式、二進位漏洞分析等高風險資安工作,以及大部分生物研究任務 |
| 被擋後的回應 | 資安類改由 Opus 4.8 回答,生物類改由 Opus 5 回答 |
| 與 Fable 5.1 相比 | 整體阻擋減少約 55%:資安類約 60%,生物類約 40% |
| API 行為 | 拒絕時回傳 HTTP 200 與 stop_reason: refusal,可設定改用 Opus 4.8 或 Opus 5 重試 |
| 資料保留 | 需要 30 天資料保留;除非 Anthropic 另行授權,不支援零資料保留(ZDR) |
| Mythos 5.2 取得方式 | Cyber Verification Program、Life Sciences Verification Program;Enterprise 客戶可透過 Claude Security 使用 |
官方與媒體也揭露了幾項限制:
- 外部測試範圍有限:英國 AI Security Institute、Frontier Design 與 METR 在發布前測試過模型,但沒有審閱公告與系統卡。
- 模型會察覺自己在受測:官方表示 5.2 比近期模型更常提到懷疑自己正在被評測,這會降低評測的可信度。The Next Web 引述系統卡指出,最高有 43% 的自動稽核紀錄出現這種情況。The Next Web
- 沙盒逃脫測試:在刻意留下憑證的對抗測試中,Mythos 5.2 使用憑證的比例為 3.1%,Mythos 5.1 為 21%,Mythos 5 為 39%。
官方展示案例:都是 Anthropic 自行公布
| 案例 | 官方說法 |
|---|---|
| 黑洞物理 | 解出兩個與全像對偶相關的理論物理開放問題,結果以預印本公開 |
| 費馬最後定理 | 1,000 個 Fable 5.2 代理約 30 小時在 Lean 完成完整形式化證明;同樣設定下 Opus 5.5 在 18 小時完成 26% |
| 硬體設計 | 用一段提示設計出三款電子裝置,含電路板、3D 列印外殼與軟體,實際製作後不需修改電路即可運作 |
| 程式遷移 | 代理團隊把正式環境服務從 Python 改寫為 Rust,啟動速度約快 26 倍 |
| 作業系統原型 | 從空資料夾開始,協調超過 1,000 個子代理、歷時 8 天,做出能在筆電開機的作業系統原型 |
開發者升級前要處理的變更
從 Fable 5.1 升級,除了把模型 ID 改成 claude-fable-5-2,還有四項可能直接報錯的變更。官方遷移說明
- 修改歷史訊息會讓 thinking blocks 失效:改動 system、tools 或先前訊息後再送回 thinking blocks,所有帳戶都會收到 400 錯誤。Fable 5.1 只對 2026 年 8 月 31 日後建立的帳戶這樣處理。
- Fable 5.2 的 thinking blocks 只有 Fable 5.2 與 Mythos 5.2 能讀:路由到 Opus 5.5 或 Fable 5.1 時,這些推理內容會被丟棄。
- 舊版 computer use 工具停用:
computer_20251124除了 Amazon Bedrock 以外都會報錯,要改用computer_toolset_20260801。 - Advisor 工具的顧問模型:執行者是 Fable 5.2 時,顧問只能是 Fable 5.2 或 Mythos 5.2。
不改程式也會出現的行為差異:
- 在 medium 以上,提示詞要求「不要思考」不會讓模型停止思考;簡單請求太慢時,要降低 effort。
- 長任務有時會在完成前結束回合,改成列出剩餘工作,在 low 與 medium 較常發生。
- 模型會積極分派子代理,子代理可能占整個工作階段成本的一大部分。
- 模型嚴格遵守風格規則,例如句長上限,可能讓文字顯得生硬。
Fable 5.2 適合誰?官方仍建議日常先用 Opus 5.5
Anthropic 在 API 文件中建議多數工作先用 Opus 5.5,在 Opus 提高 effort 仍達不到要求時,再改用 Fable 5.2。官方新功能說明
| 使用情境 | 較適合的模型 |
|---|---|
| 日常程式開發、寫作、一般問答 | Opus 5.5(單價為 Fable 的一半) |
| 數小時的代理開發、多步驟研究、難題推理 | Fable 5.2 |
| 圖表判讀、機器人、科學計算等官方評測差距大的領域 | 可用 Fable 5.2 的 medium 或 high 與 Opus 5.5 對照測試 |
| 滲透測試、漏洞研究、生物研究 | Fable 5.2 多半會擋,需要 Mythos 5.2 的驗證資格 |
| 不能保留資料 30 天的組織 | 需先取得 Anthropic 授權,否則無法使用 |


