
Claude Opus 5.5 上線:AA 登頂、價格降幅與完整評測解析
Claude Opus 5.5 正式上線,Artificial Analysis 的最新智慧指數以 58 分登上第一名。 這次最值得注意的,是更高的能力上限與更低的使用單價同時出現;但「58 分」用的是最高推理強度,「成本降低 40%」則是官方對預設設定下典型工作的估計,兩者不能直接拼成同一個使用情境。
本文對照 Anthropic 公告、API 文件、官方完整評測圖與 Artificial Analysis 即時頁面,整理到底進步在哪裡、怎麼計價,以及升級時容易踩到的地方。這是發布首日的資料分析,未宣稱已完成本站實機評測。
Opus 5.5 先看重點:上線日期、規格與使用入口
Anthropic 官方發布日期為 2026 年 9 月 22 日;本文於台灣時間 9 月 23 日凌晨查核。API 規格如下,別把 API 的上限直接當成每個訂閱介面都會提供的額度。官方模型文件
| 項目 | 已確認資訊 |
|---|---|
| Claude API 模型 ID | claude-opus-5-5 |
| 上下文視窗 | 100 萬 tokens |
| 一般 API 最大輸出 | 128K tokens |
| 輸入/輸出類型 | 文字、圖片輸入;文字輸出 |
| 推理機制 | Adaptive thinking 持續開啟,預設 medium |
| Claude 訂閱入口 | Pro、Max、Team、Enterprise |
| 開發者入口 | Claude API、Amazon Bedrock、Claude Platform on AWS、Google Cloud、Microsoft Foundry |
訂閱方案可用性見 Opus 產品頁,雲端平台清單見 API 發布紀錄。各平台仍有自己的帳戶權限與設定。
Artificial Analysis 已更新:58 分第一,但要看 effort
查核時,Artificial Analysis Intelligence Index v4.3.2 的 Opus 5.5 模型頁顯示 58 分、排名第一。首頁同時顯示 Fable 5.1 為 53 分、GPT-6 Astra 為 53 分;這些是頁面顯示的整數分數。兩個 Claude 條目都帶有 max with fallback,GPT-6 Astra 則是 max。AA 即時排行榜
AA 也同時列出 Opus 5.5 的五種推理強度。下表每列都保留 Default Fallback 條件,token 數是整套 Intelligence Index 評測的累計輸出量,不是單次回答長度或上下文容量。
| Opus 5.5 推理強度 | AA 智慧指數 | 評測累計輸出 tokens |
|---|---|---|
| max | 58 | 約 2.6 億 |
| xhigh | 56 | 約 1 億 |
| high | 54 | 約 5,300 萬 |
| medium | 51 | 約 3,800 萬 |
| low | 42 | 約 2,000 萬 |
我的解讀:日常開發值得先測 medium 與 high,再決定哪些難題需要 max。 以 AA 顯示的四捨五入數字計算,max 的總輸出量約為 medium 的 6.8 倍,換來 7 分差距。這不是帳單倍率,因為還沒納入輸入、快取與其他費用;但足以提醒我們,榜首設定不一定適合每一次呼叫。
另外,查核時 AA 新模型頁的速度與每任務成本仍標示 N/A,部分價格欄顯示 $0.00,與 Anthropic 已公布的付費價格不符。本文因此採官方價目表,不把該欄位解讀成免費,也不推算尚未公布的實測速度。AA 模型頁
官方九項評測:程式開發領先,Astra 仍有強項
以下數字來自 Anthropic 發布的比較圖,與公告表格逐項核對。這是官方彙整的評測結果,與上一節 AA 的綜合智慧指數是不同資料。「未列」表示官方圖沒有提供該格成績,不代表零分。官方發布公告與評測
| 評測 | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 55.8% | 52.3% | 57.9% | 37.3% |
| FrontierCode v1.1(Main) | 54.4% | 50.3% | 48.0% | 53.3% | 47.5% |
| CursorBench 4.0 | 57.8% | 51.8% | 46.6% | 未列 | 41.7% |
| GDPval-AA v2.1 | 1846 | 1735 | 1708 | 1542 | 1588 |
| AutomationBench | 40.0% | 31.4% | 26.9% | 41.4% | 28.8% |
| Humanity’s Last Exam(含工具) | 67.7% | 65.6% | 63.6% | 57.2% | 未列 |
| Terminal-Bench-Science 0.1 | 58.7% | 52.6% | 29.0% | 64.6% | 22.4% |
| OSWorld 2.0(partial) | 81.8% | 80.7% | 74.0% | 未列 | 未列 |
| Chartography(含工具) | 89.0% | 88.4% | 83.4% | 未列 | 未列 |
GDPval-AA 這一列是評分,不是百分比;OSWorld 的 partial 與其他列的工具條件也都保留,避免把不同口徑看成同一種正確率。
最明顯的變化在 Terminal-Bench:Opus 5.5 比 Opus 5 高 14.1 個百分點,比 Astra 高 8.5 個百分點。但 FrontierCode 對 Astra 只高 1.1 個百分點;商業流程與代理科學研究的表中最高分,仍是 Astra。用這張圖宣稱「所有工作全面輾壓」就太過頭了。
閱讀時還有三個條件不能省略:
- Opus 5.5 多數列使用 max,Terminal-Bench 則使用 xhigh;Astra 的該列使用 high,並非統一 effort 的對照實驗。
- 官方啟用正式環境防護,部分題目可能交由舊模型完成;AutomationBench 由 Zapier 執行且不使用 fallback,觸發防護即算失敗。
- Terminal-Bench 的 Opus 5.5 標準誤為 ±2.6 個百分點;科學研究測試各模型約 ±3.5–5 個百分點。小差距不宜直接解讀為穩定勝負。
展開官方完整評測原圖與註腳
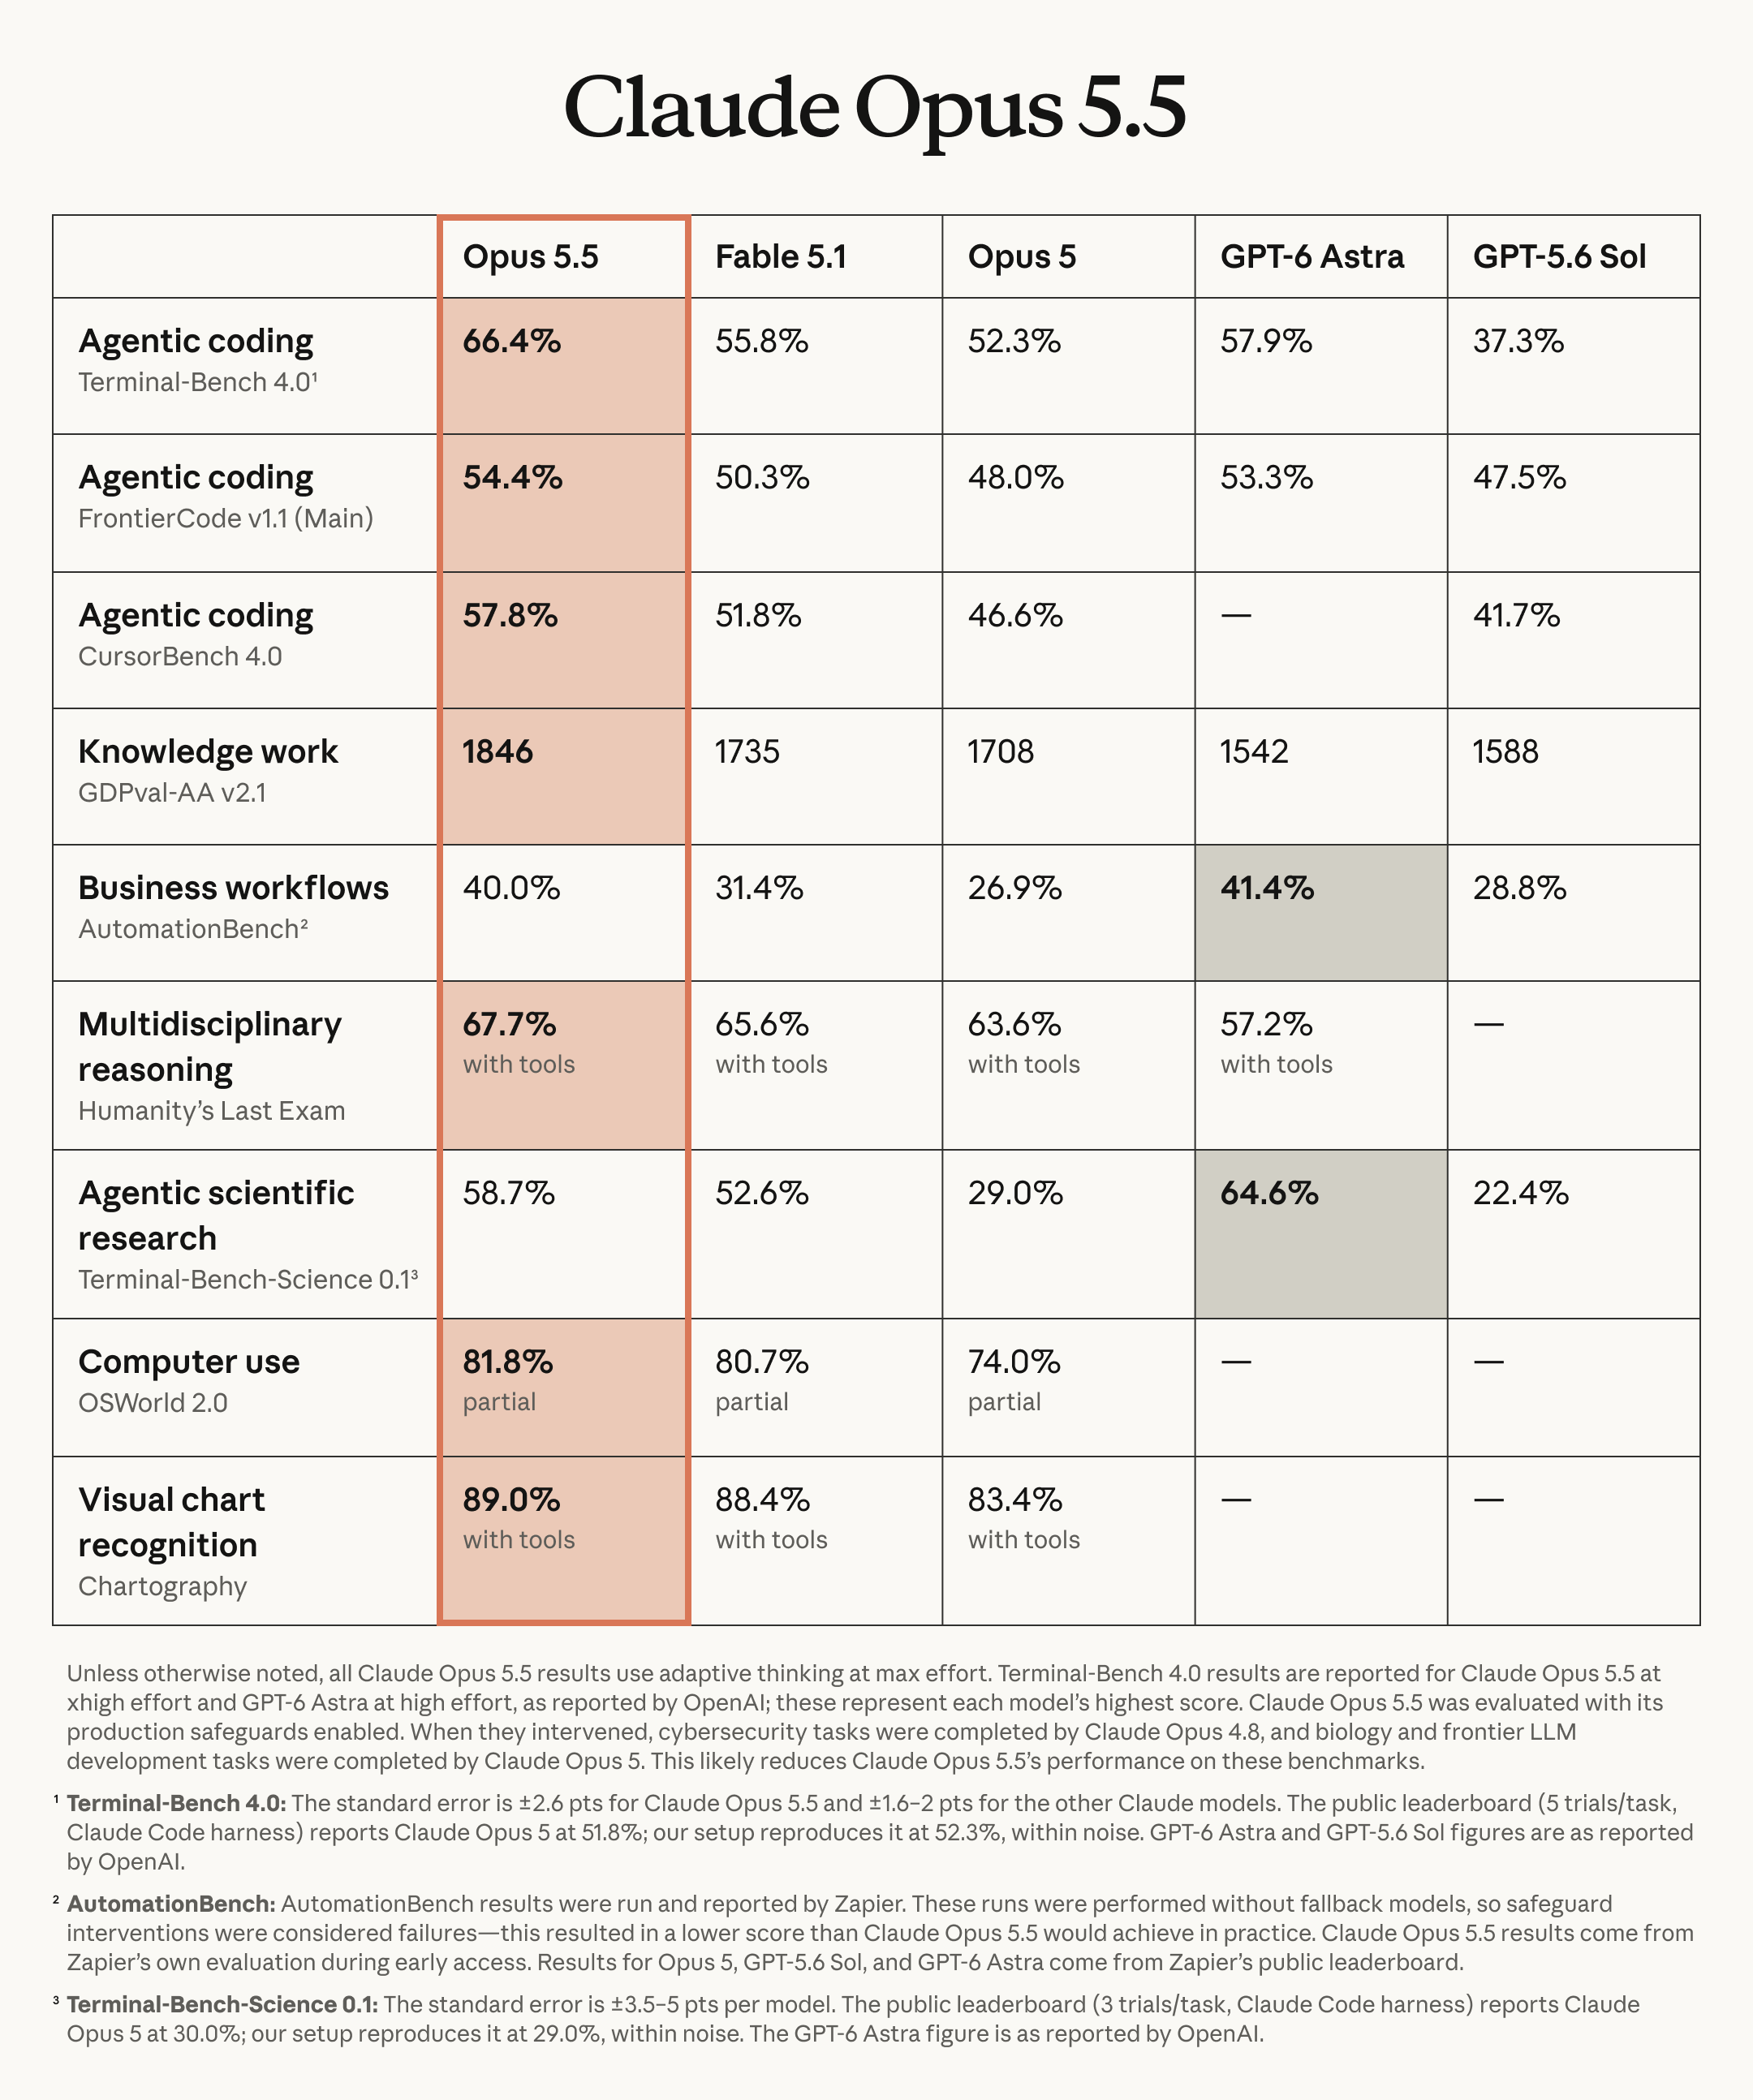
圖片來源:Anthropic 官方發布資料,保留原圖數字與註腳。
價格到底降多少?20%、40%、60% 各有意思
以下為標準 Claude API 價格,單位均為 美元/100 萬 tokens。官方價格文件
| 計費項目 | Opus 5 | Opus 5.5 | 單價降幅 |
|---|---|---|---|
| 一般輸入 | $5 | $4 | 20% |
| 輸出 | $25 | $20 | 20% |
| 5 分鐘快取寫入 | $6.25 | $5 | 20% |
| 1 小時快取寫入 | $10 | $8 | 20% |
| 快取命中讀取 | $0.50 | $0.20 | 60% |
40% 指的是 Anthropic 對典型任務總成本的估計,包含單價與 token 使用效率的變化,並非所有計費項目都打六折。官方另稱一般輸出生成速度比 Opus 5 快超過 30%;這也不是整個專案必定快 30% 的保證。官方公告
自己算一個固定用量的例子就很清楚:假設未命中快取的輸入為 100 萬 tokens、輸出為 20 萬 tokens,且不計工具等額外費用,Opus 5 是 $10,Opus 5.5 是 $8,省的是 20%。若模型還能減少嘗試次數、縮短輸出或提高快取命中率,總成本才會繼續下降。
對反覆讀同一套程式碼的代理工作,快取值得特別看:相同的 1,000 萬快取讀取 tokens,讀取費由 $5 降到 $2;初次寫入與輸出仍需另計。
Fast mode 則另收較高費率:Opus 5.5 輸入 $8、輸出 $40,官方稱最高可達一般模式的 2.5 倍速度。別把 Fast mode 與標準模式混算。以相同 token 數計,Opus 5.5 標準輸入/輸出單價也比 Fable 5.1 的 $10/$50 低 60%,但這仍不是兩個模型每項工作的總價差。Opus 產品頁、模型規格對照
Pro、Max、Team 額度與可自行使用的重設
Anthropic 同步宣布提高 Pro、Max、Team 的五小時用量上限,並提供訂閱使用者可自行選擇時機使用的額度重設。發布公告未列統一增幅,不宜自行寫成「全部翻倍」。官方公告
有拿到重設的帳戶,可在網頁版或桌面版 Settings → Usage → Resets → Reset for free 查看與使用。重設的是五小時或每週額度,依帳戶顯示的優惠為準;到期時間也看頁面標示。手機與 Claude Code 終端目前沒有該按鈕,但重設後會共用帳戶額度。官方重設說明
這是用量權益調整,不等於 Pro 或 Max 的月費跟著 API 單價一起降價。評估訂閱方案時,可以接著看本站的 AI 開發工具訂閱比較,並留意文章中的資料日期。
開發者升級前,先處理四項不相容變更
如果你只在 Claude 介面切換模型,通常不需要處理 API 參數;但自行串接 Messages API 的程式,不宜只替換模型名稱就直接切正式流量。
- 不能關閉 thinking:舊的
thinking.type: "disabled"或"enabled"設定會報 400。改用 effort 控制推理深度。 - 不能強制指定工具呼叫:
tool_choice的any、tool不再支援。依需求改用auto搭配 strict tool use 或 structured outputs;其中 strict 約束的是工具參數格式,並不保證模型一定呼叫工具。API 發布紀錄 - thinking blocks 綁定模型與對話:中途改寫 system、工具或舊訊息,可能使重播的 thinking blocks 失效;跨模型路由也要檢查相容性。
- computer use 工具有平台差異:Claude API 與 Google Cloud 要改用
computer_toolset_20260801;Amazon Bedrock 仍支援舊的computer_20251124。官方遷移指南
還有一項不一定報錯、卻很容易讓產品看起來故障的變化:工具呼叫之間的進度文字改放在 thinking blocks,預設顯示設定不會提供文字。若你的介面原本靠 text blocks 顯示「正在處理」,要同步調整回應解析。模型文件的回應格式說明
我會怎麼選:先比較完成工作的代價
對正在用 Opus 5 寫程式的人,我會把 Opus 5.5 列為優先試用對象。 選一個你熟悉、能驗收結果的真實任務,同時記錄修正次數、測試結果、耗時和總費用,再決定是否作為預設模型。AA 的 effort 表很適合拿來規劃 medium、high、max 的試跑順序。
如果你主要做科學研究或跨系統商業流程,保留 Astra 做同題比較仍有價值;官方表本身就顯示這兩個領域的差異。要從 Fable 5.1 轉過來,也應先驗證自己的高難度工作是否維持品質,再把單價優勢算進去。
最後,with fallback 是實際使用條件的一部分:官方說明某些請求會切換到其他模型,介面會標示回應者。因此做自己的測試時,也記得確認到底是哪個模型完成工作。官方模型切換說明
本文採用 2026 年 9 月 23 日凌晨查核的官方文件與 AA 頁面;排行榜、供應平台與帳戶權益會持續更新。官方另預告 Sonnet 5.5、Haiku 5.5 將於接下來幾週推出,目前不能把它們寫成已同步發布。發布公告


